Field note · 2026
Software Factory:AI Native 软件开发流程的新范式
2026 年 8 月 12 日,Vercel 在 X 上发了一条很短的帖子:他们为 AI SDK 建了一套 Software Factory。每个步骤由一个 Agent 负责,人类保留合并权;运行四周后,Factory 参与编写了最高 35% 的合并 PR,处理了 7 月 70% 的关闭 issue,开放 bug 数下降 25%。Vercel X
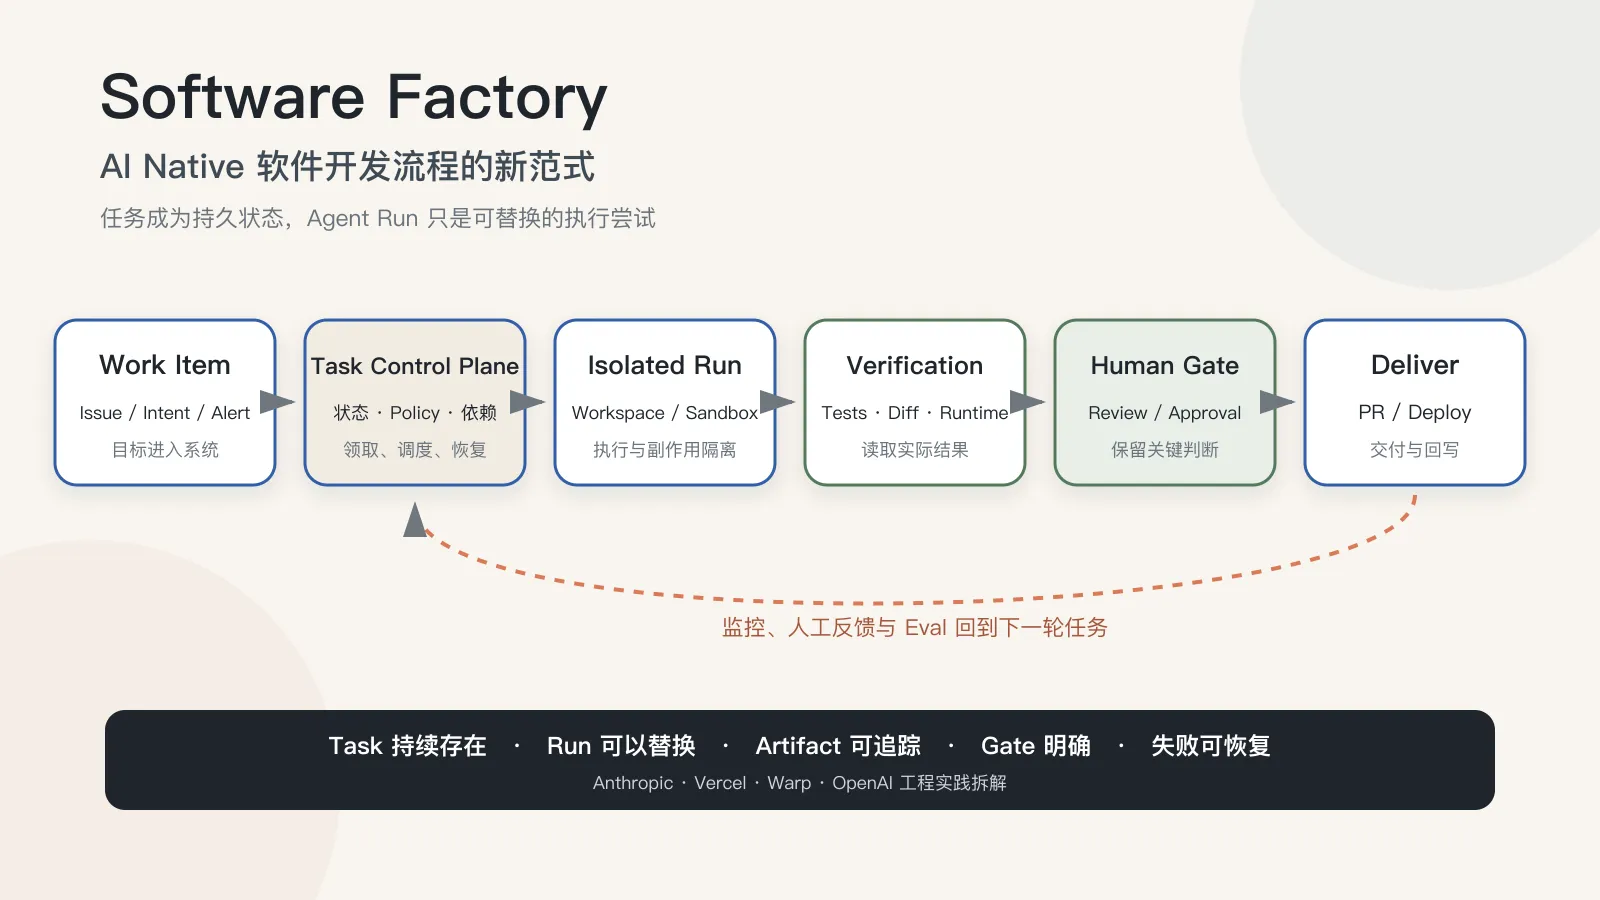
2026 年 8 月 12 日,Vercel 在 X 上发了一条很短的帖子:他们为 AI SDK 建了一套 Software Factory。每个步骤由一个 Agent 负责,人类保留合并权;运行四周后,Factory 参与编写了最高 35% 的合并 PR,处理了 7 月 70% 的关闭 issue,开放 bug 数下降 25%。Vercel X
六天后,Warp 用同一个词发布 Warp Factories:Factory 可以像基础设施一样用代码配置,按阶段选择不同模型和 harness,从 Slack、Linear、Jira 或 GitHub 接收任务,在云端运行 Agent,再用 eval、benchmark 和成本指标持续调整。Warp X
同一个 Software Factory,指向的却是两种系统。
Vercel 回答“怎样用 Agent 维护一个每周下载量超过 2000 万的开源 SDK”:issue 进来后,系统先判断它是不是 bug,再复现、分析、实现、审核、回移植,最后由 Maintainer 合并。Warp 回答另一个问题:怎样把这套流程做成其他公司也能部署的控制面。
放进更完整的技术脉络,Anthropic 在 8 月 21 日发布了 AI-Native SDLC Playbook,OpenAI 则先后公布了 Harness Engineering 和 Symphony:前者讨论怎样让仓库、浏览器、日志和架构约束对 Agent 可见,后者把 Linear 变成 Coding Agent 的任务控制面。
这些材料放在一起,Software Factory 的边界就清楚了:它在 Agent Session 之外建立一套持续运行的工程系统。当 Coding Agent 离开一对一交互,任务由谁持有,失败怎样重试,环境怎样隔离,过程留下什么 artifact,验证与审核如何分开,什么动作必须等人,运行经验如何进入下一次执行,都不能再留给某个窗口里的临时上下文。
本文的研究截点是 2026 年 8 月 31 日。涉及自动化比例、PR 数量和效率的数据,除公开 GitHub 记录外,均按公司第一方数据处理。
先划边界:开更多 Agent 还不是 Factory
围绕 AI Coding 的产品名词已经混在一起。Claude Code、Codex、Background Agent、Agent Teams、Orchestrator、Software Factory 都能改代码、跑测试、开 PR,但它们解决的不是同一层问题。
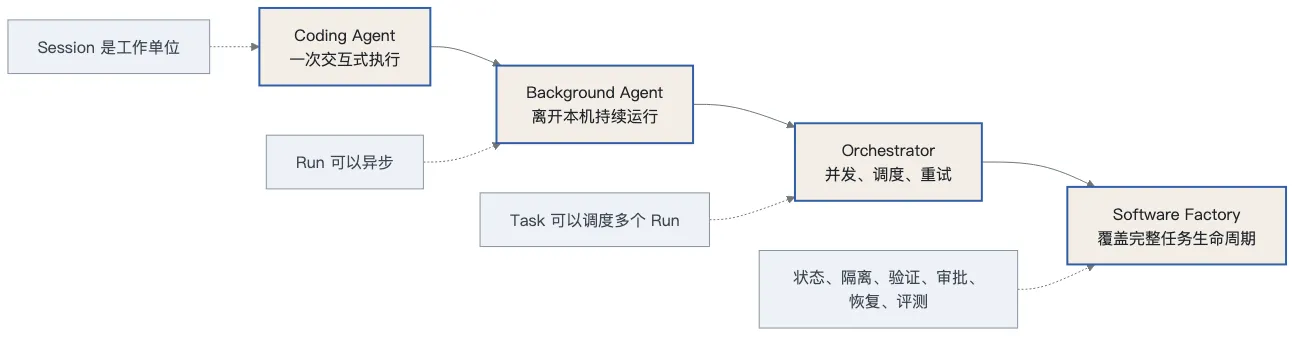
图 1:AI Coding 系统从单个 Session 走向 Software Factory,新增的不只是“更多 Agent”,而是异步运行、跨任务调度和完整生命周期管理。
Coding Agent 的基本单位是 Session。人给出目标,Agent 在当前仓库里读取、修改、执行和验证。即便它内部调用 subagent,工作仍围绕这一轮上下文展开。
Background Agent 把 Run 从开发者的电脑和当前会话里解耦。人可以关掉终端,任务继续在云端或远程环境运行。但它通常仍然只负责一个任务的执行。
Orchestrator 开始管理多个 Run:并发上限、任务领取、工作目录、重试、取消、超时和状态汇总。OpenAI Symphony 就把自己严格定义为 scheduler/runner,而不是一套通用业务工作流引擎。Symphony SPEC
Software Factory 再向外扩一层。它覆盖从需求进入到交付和反馈的完整生命周期,并为每个阶段保存状态、artifact、权限和验证结果。Agent 可以换,模型可以换,某一次 Run 也可以失败;Task 仍然存在,系统知道下一步该重试、暂停、升级给人,还是进入后续阶段。
六个问题足以判断一套系统是否越过了 Factory 的门槛:
- 一个 Agent 进程退出后,任务还存在吗?
- 同一任务的第二次 Run 能否知道第一次为什么失败?
- 代码之外的 Spec、验收标准、测试结果和审核意见是否是正式 artifact?
- 系统能否区分“执行成功”和“任务完成”?
- 高风险动作是否有独立于 prompt 的权限边界?
- 失败会只触发一句“再试一次”,还是沉淀为环境、规则或 eval 的改进?
如果这些答案都落在某个开发者的脑子、某个聊天窗口或一段临时脚本里,它仍然更像一组 Agent 工具,而不是 Factory。
一条任务怎样穿过 AI Native SDLC
四家公司的流程名字不同,但可以抽象成同一条主干:
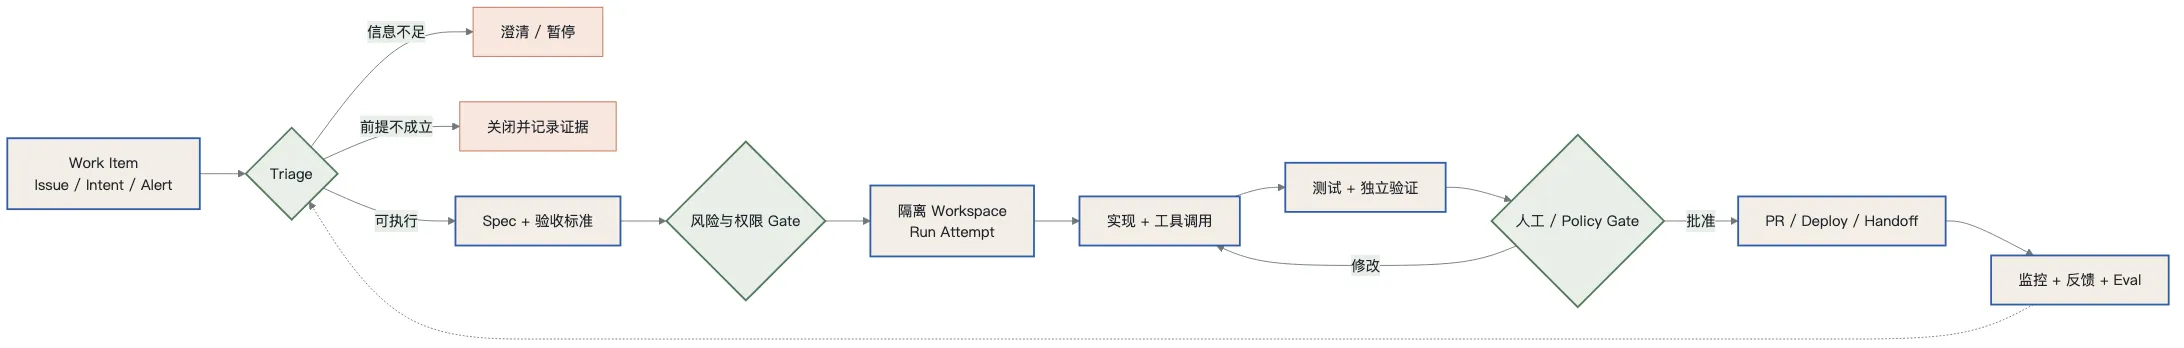
图 2:Software Factory 的通用主干。Spec、Plan 和验证结果都作为持久 artifact,在风险 Gate、人工审批和反馈闭环之间传递。
1. Work item 先变成可处理的任务
入口可以是一条 GitHub issue、一份 intent.md、Linear ticket、Slack 消息,也可以是监控系统产生的告警。无论入口是什么,系统都不能把输入文本直接当成事实。
Vercel 的 Factory 会先判断 issue 属于 bug、feature 还是 documentation;Anthropic 的 Playbook 要求先把想法整理成 intent.md;Warp 用 foreman agent 路由到 triage、spec 或 implementation。一个成熟入口至少需要判断:信息是否完整、前提是否成立、任务风险多高、是否适合自动化。
“没有代码变更”也必须是合法结果。Vercel 的教学版 Factory 专门设计了一类 case:issue 声称存在 bug,但 Investigator 运行真实检查后发现仓库已经拒绝了这个错误输入。正确输出不是勉强改几行代码,而是保存反证并停止。Vercel Academy
2. Spec 和验收标准必须先于实现
Coding Agent 能从一句模糊描述直接开始改代码,Factory 却不能把这种偶然性固化成默认流程。
Anthropic 把 intent、requirements、design、plan 分成连续 artifact;Vercel 的 analyst 会在真实 checkout 上生成计划、风险、acceptance criteria 和 test strategy;OpenAI 的 Harness Engineering 则把复杂工作的 execution plan 与决策日志放进仓库,让未来 Agent 不必依赖某次对话的上下文。
Spec 为后面的独立验证提供参照,并不负责写死每个实现决定。没有它,Reviewer 只能问“代码看起来合理吗”,无法回答“它是否完成了原始目标”。
3. 每次执行都发生在一个有边界的 Workspace
Agent 不应该在开发者登录了所有系统的个人电脑上,以继承来的全部权限运行无人值守任务。
Vercel 为不同 station 创建独立 Sandbox;OpenAI Harness Engineering 为每个 worktree 启动独立应用、日志、指标和 trace;Ramp 的 Inspect 把 Vite、Postgres、Temporal 以及 Sentry、Datadog、LaunchDarkly 等验证入口放进隔离 VM。Ramp
Workspace 不只是一份 Git checkout。它是一次执行的副作用容器:当前分支、未提交文件、依赖、进程、测试数据库、浏览器状态和工具凭据都属于它。Task 可以跨 Run 存在,Workspace 可以被保留或重建,但两者不能混为一个对象。
4. 验证必须读取实际结果,而不是执行者的自述
实现 Agent 最容易给出的证明,是一段“我修改了什么、测试已通过”的总结。它可以帮助导航,却不是独立证据。
更可靠的做法是让 Verifier 读取真实 diff 和 checkout 的实际分支,运行仓库自己的检查,必要时启动应用并观察 UI、日志或指标。Vercel 开源的 eve Factory 模板甚至让 Reviewer 使用不同厂商的模型,只读取已 push 的 branch,不继承 Implementer 的 reasoning。这样至少能降低 Reviewer 沿着同一条错误思路继续自洽的概率。eve Software Factory Template
5. Gate 决定流程能不能继续
Gate 必须落到运行时策略,不能停在一句“请谨慎操作”的 system prompt 里。
低风险文档修正可以自动准备 draft PR;公共 API 变更需要产品或 Maintainer 判断;生产部署需要命名授权;无人值守任务可以评论、打标签、推 feature branch,却不应该拥有 merge 工具。把工具从 surface 中移除,通常比告诉模型“不要调用它”更可靠。
6. 失败要进入恢复或改进,而不是消失
一次 Run 可能成功、失败、超时、卡住、需要输入,或者已经执行外部动作但没有拿到确认。Factory 必须把这些结果翻译成明确的状态转换。
有些失败适合重试;有些需要补环境或凭据;有些说明 Spec 有问题;有些意味着任务必须回到人工判断。将所有失败都处理为“原 prompt 再跑一遍”,只会把偶发错误放大成重试风暴。
Anthropic:先把整个 SDLC 改写成 Artifact Loop
Anthropic 的材料最适合回答“AI Native 流程应该长什么样”,但它不是一份完整 Factory 产品说明书。
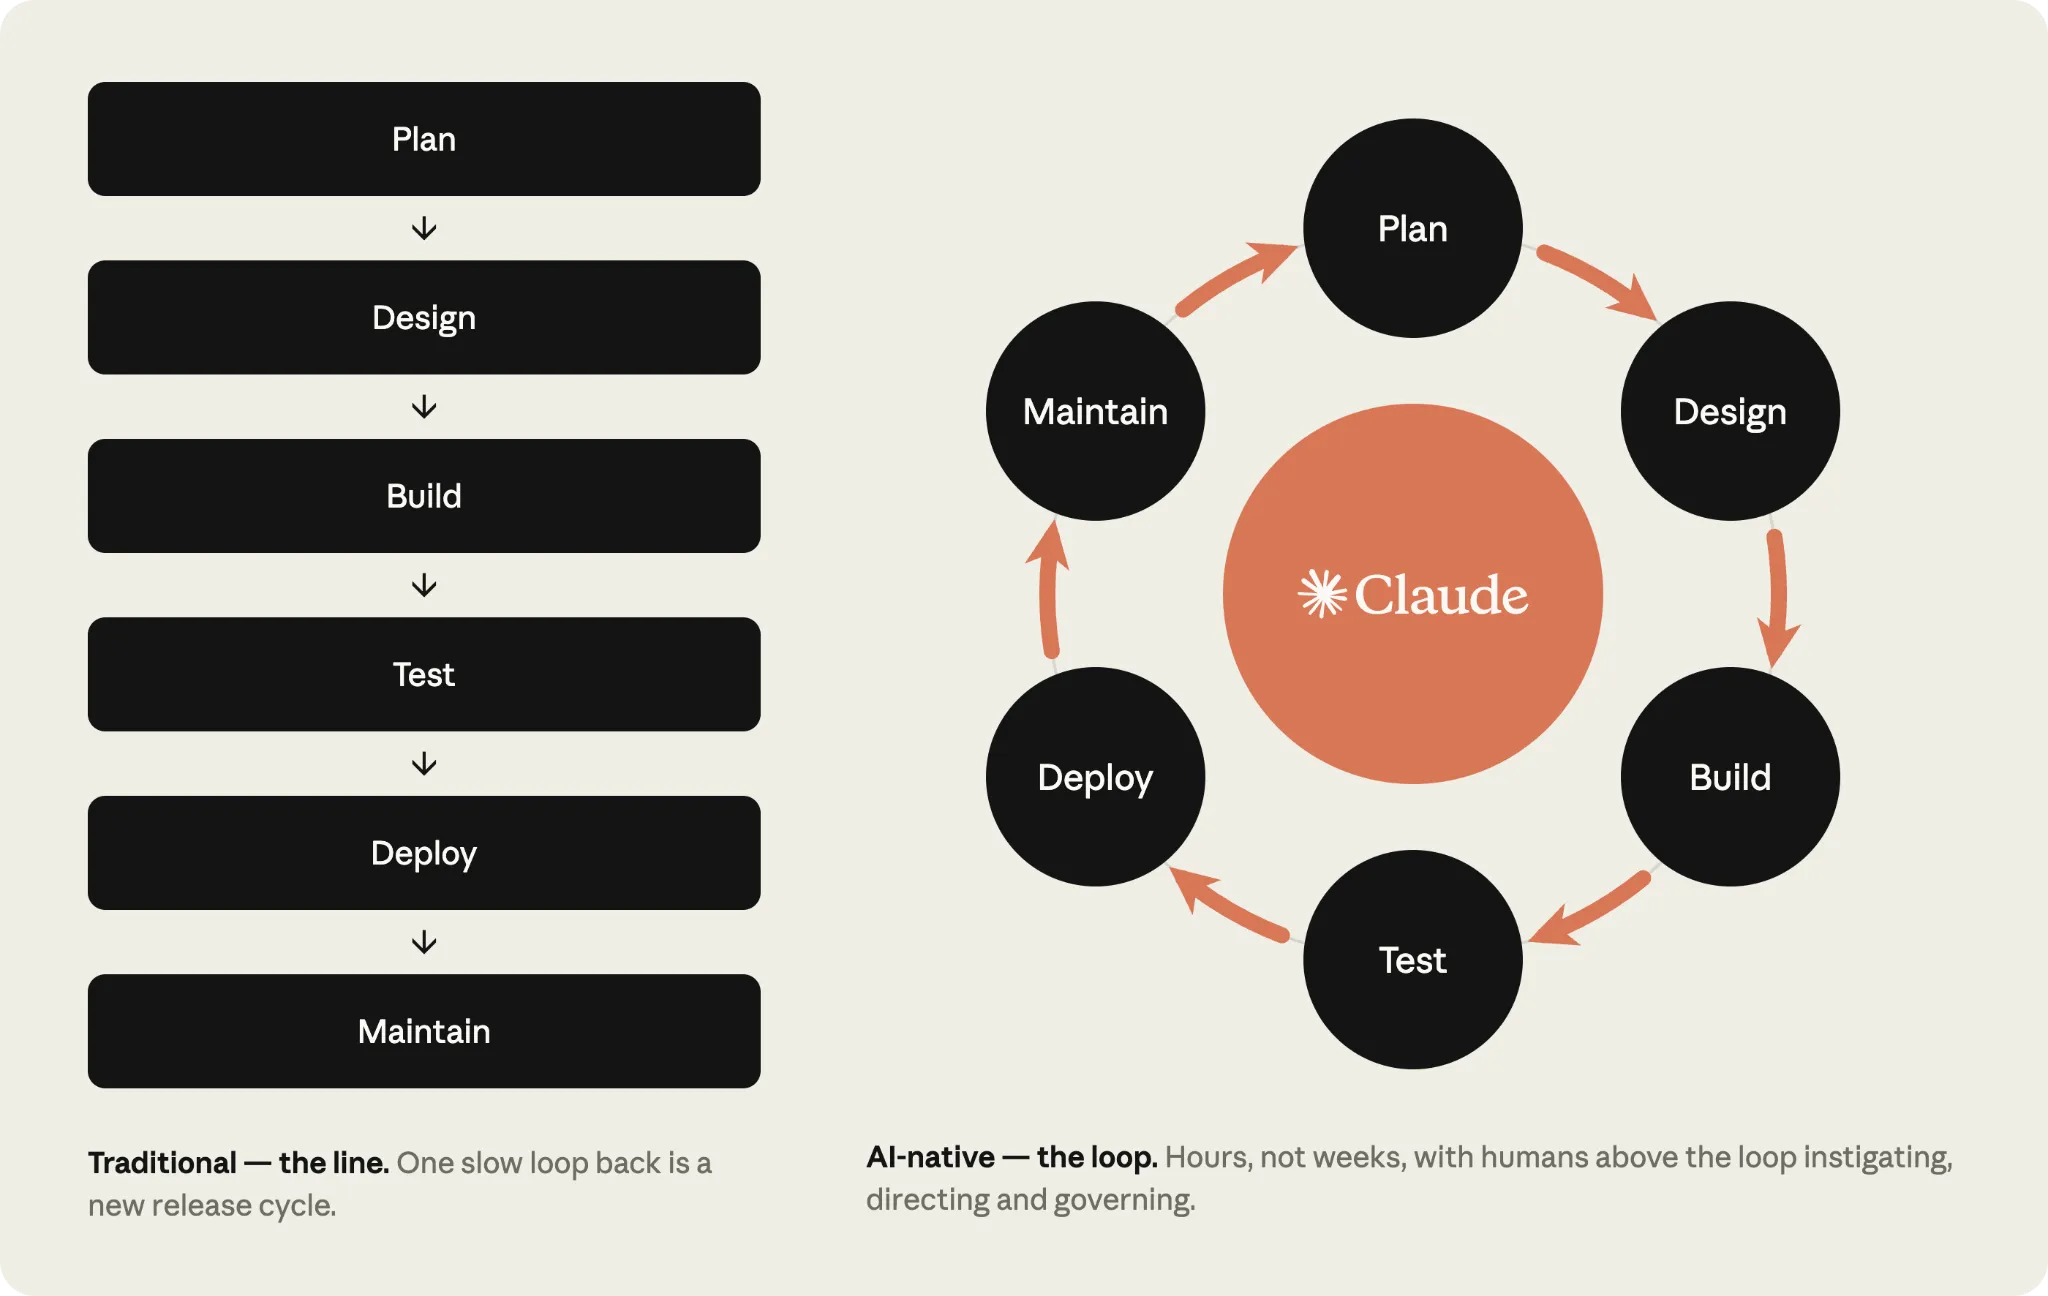
图 3:Anthropic 将传统线性 SDLC 改写成 Plan、Design、Build、Test、Deploy、Maintain 的持续循环。来源:Anthropic, The AI-Native SDLC Playbook。
Playbook 并没有在六个阶段里各塞一个 Claude。它要求每个阶段产生下游可以直接消费的版本化 artifact:
| 阶段 | 主要 artifact | 下一步如何触发 |
|---|---|---|
| Plan | intent.md | 产品负责人接受后进入 requirements / design |
| Design | spec.md | Spec 审核后进入实现计划 |
| Build | plan.md、代码、测试 | 计划批准后执行,偏离计划必须同步更新 |
| Test | Evals、测试与验证结果 | 在实现过程中持续运行,不只守在末端 |
| Deploy | Review 结果、审批记录、发布 artifact | Hooks 与 CI/CD 执行 Gate |
| Maintain | 指标、告警、诊断结果 | 越过控制带时生成新的 intent |
CLAUDE.md、Skills 和 Hooks 在这里承担不同责任。CLAUDE.md 告诉 Agent 如何在这个仓库工作;Skill 承载需要跨项目或跨团队稳定执行的组织流程;Hook 把关键限制变成确定性的运行时动作。它们不应该合并成一份越来越长的“万能提示词”。
Agent 配置本身也要回归测试。Playbook 建议收集 20 到 50 个真实任务,把预期结果写成 eval;任何 CLAUDE.md、Skill 或 Hook 的修改,都在 CI 中重新跑这组任务。这样“让 Agent 学会新规则”才不会悄悄破坏旧能力。
但证据边界要画清楚:Anthropic 将这份材料描述为 Applied AI 团队的内部和客户实践总结。它证明了方法论和可操作步骤,不等于公开证明 Anthropic 已经用一个统一 Factory 在所有仓库跑完这条全链路。
Vercel:公开仓库里跑起来的 AI SDK Factory
Vercel 的案例最具体:架构和数字之外,它还留下了公开 issue、PR 和 bot 轨迹。
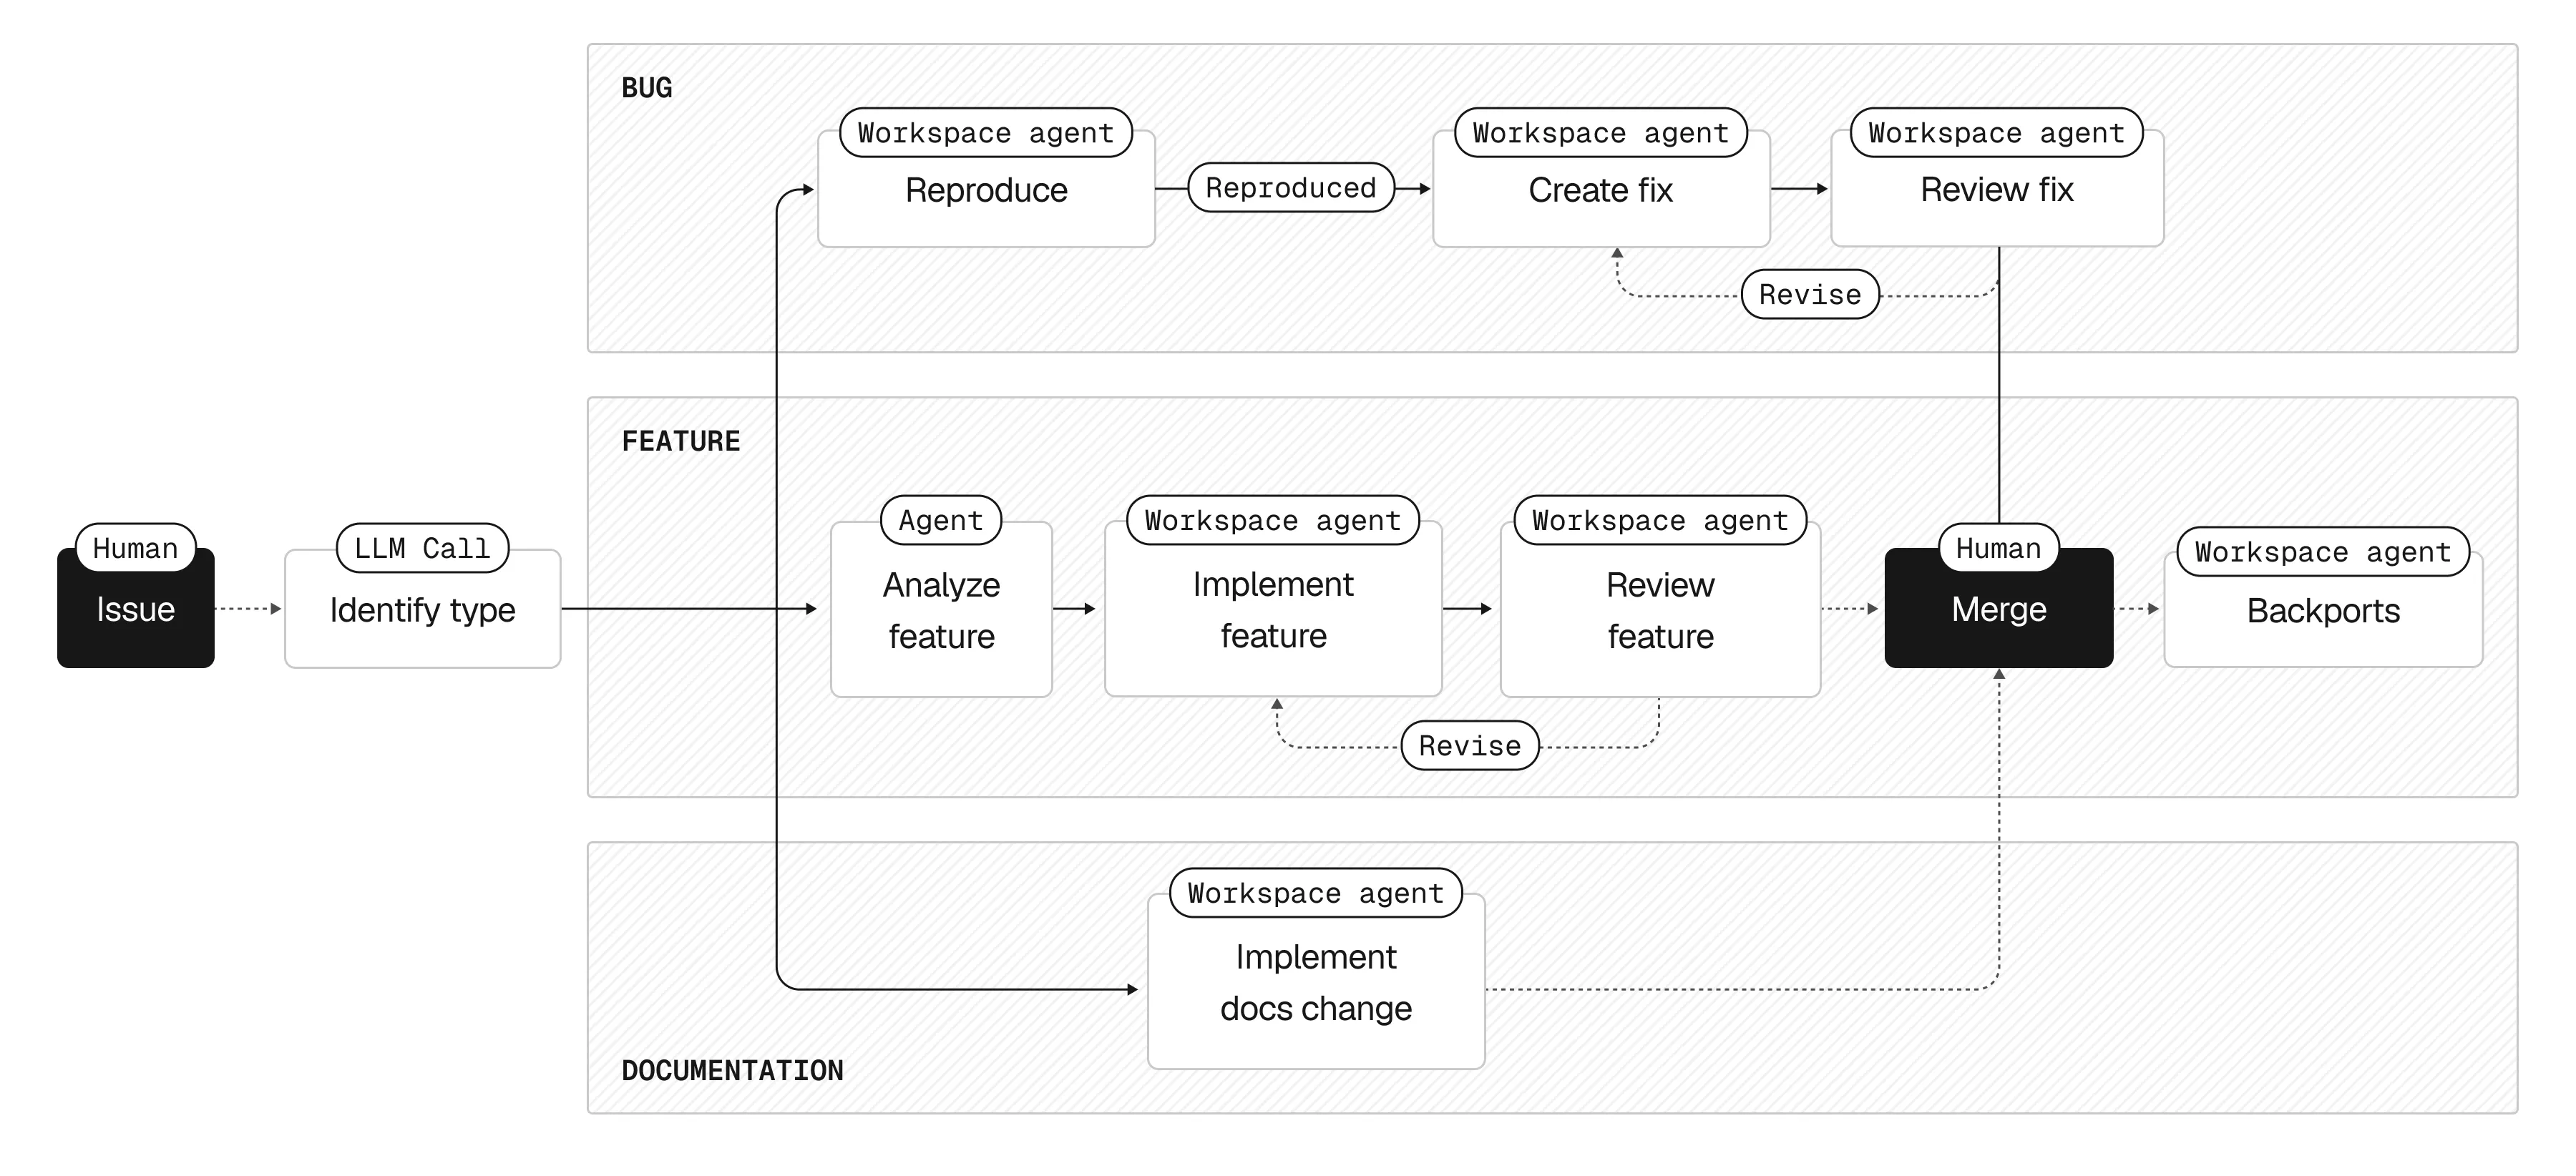
图 4:Vercel AI SDK Factory 先按 Bug、Feature 和 Documentation 分流 Issue,再由独立工位分别复现、实现、审核和回移植。来源:Vercel, Building a software factory for AI SDK。
AI SDK 同时追赶模型供应商、UI framework、Sandbox 和 Coding Harness。到 2026 年 6 月底,官方称仓库积累了 1022 个 open issue 和接近 800 个 PR。继续给 Maintainer 增加 Coding Agent,只会让代码生产速度更快,无法解决所有变更仍要经过同一个人判断的问题。
Vercel 因此没有先追求完全自治,而是先优化 Reviewer 的工作包。一个进入 Factory 的 feature 会经历:
- Classifier 判断类型和可执行性;
- Analyst 在真实仓库上确认问题、生成 probe、写 Spec 与验收标准;
- Implementer 在独立 Sandbox 中实现并运行检查;
- Reviewer 对实际分支逐条验证 acceptance criteria;
- 人类阅读证据链、检查 diff 并决定是否合并;
- 合并后,Backport Agent 尝试将改动带回旧版本。
公开的 issue #17898 提议为 OpenAI web search 增加 blocked-domain 支持。Factory 先生成 probe,确认 main 确实缺少这一能力,再形成 Spec;随后 ai-sdk-factory[bot] 创建 PR #18033,修改 11 个文件,增加 111 行、删除 9 行,并运行真实 web search 端到端验证。人类合并后,Factory 又创建 v6 和 v5 的 #18035、#18036 两个 backport。v5 出现冲突后,Agent 修正并继续完成回移植。
这条公开轨迹里有几项可直接借用的设计:
- 一个 Agent 只承担一个可单独测试的职责;
- Analyst 不写代码,Reviewer 不继承 Implementer 的上下文;
- 长文档以 artifact ID 交接,而不是塞回 Orchestrator 的整段 prompt;
- 无人值守流程最高只能创建 draft PR;
- merge 工具根本不在 Agent tool surface 中;
- 来自 public issue、comment、diff 的内容统一按不可信输入处理。
Vercel 报告运行四周后,Factory 编写了每周 25%~35% 的合并 PR,7 月超过 75% 的关闭 issue 由 Factory 处理,open issue 从 1022 降到 844,open bug 下降约 25%。X 宣传帖把 issue 数字取整为 70%,长文给出的口径是超过 75%。这些数字有公开仓库可供抽样,但统计口径、长期缺陷率和维护成本仍是第一方数据;四周也不足以证明这种方式已经跨过长期演化的考验。
Warp:把 Factory 做成一层可配置的控制面
Vercel 在运营一条具体的开源维护流程,Warp 则把建立和运营这类流程的能力做成产品。
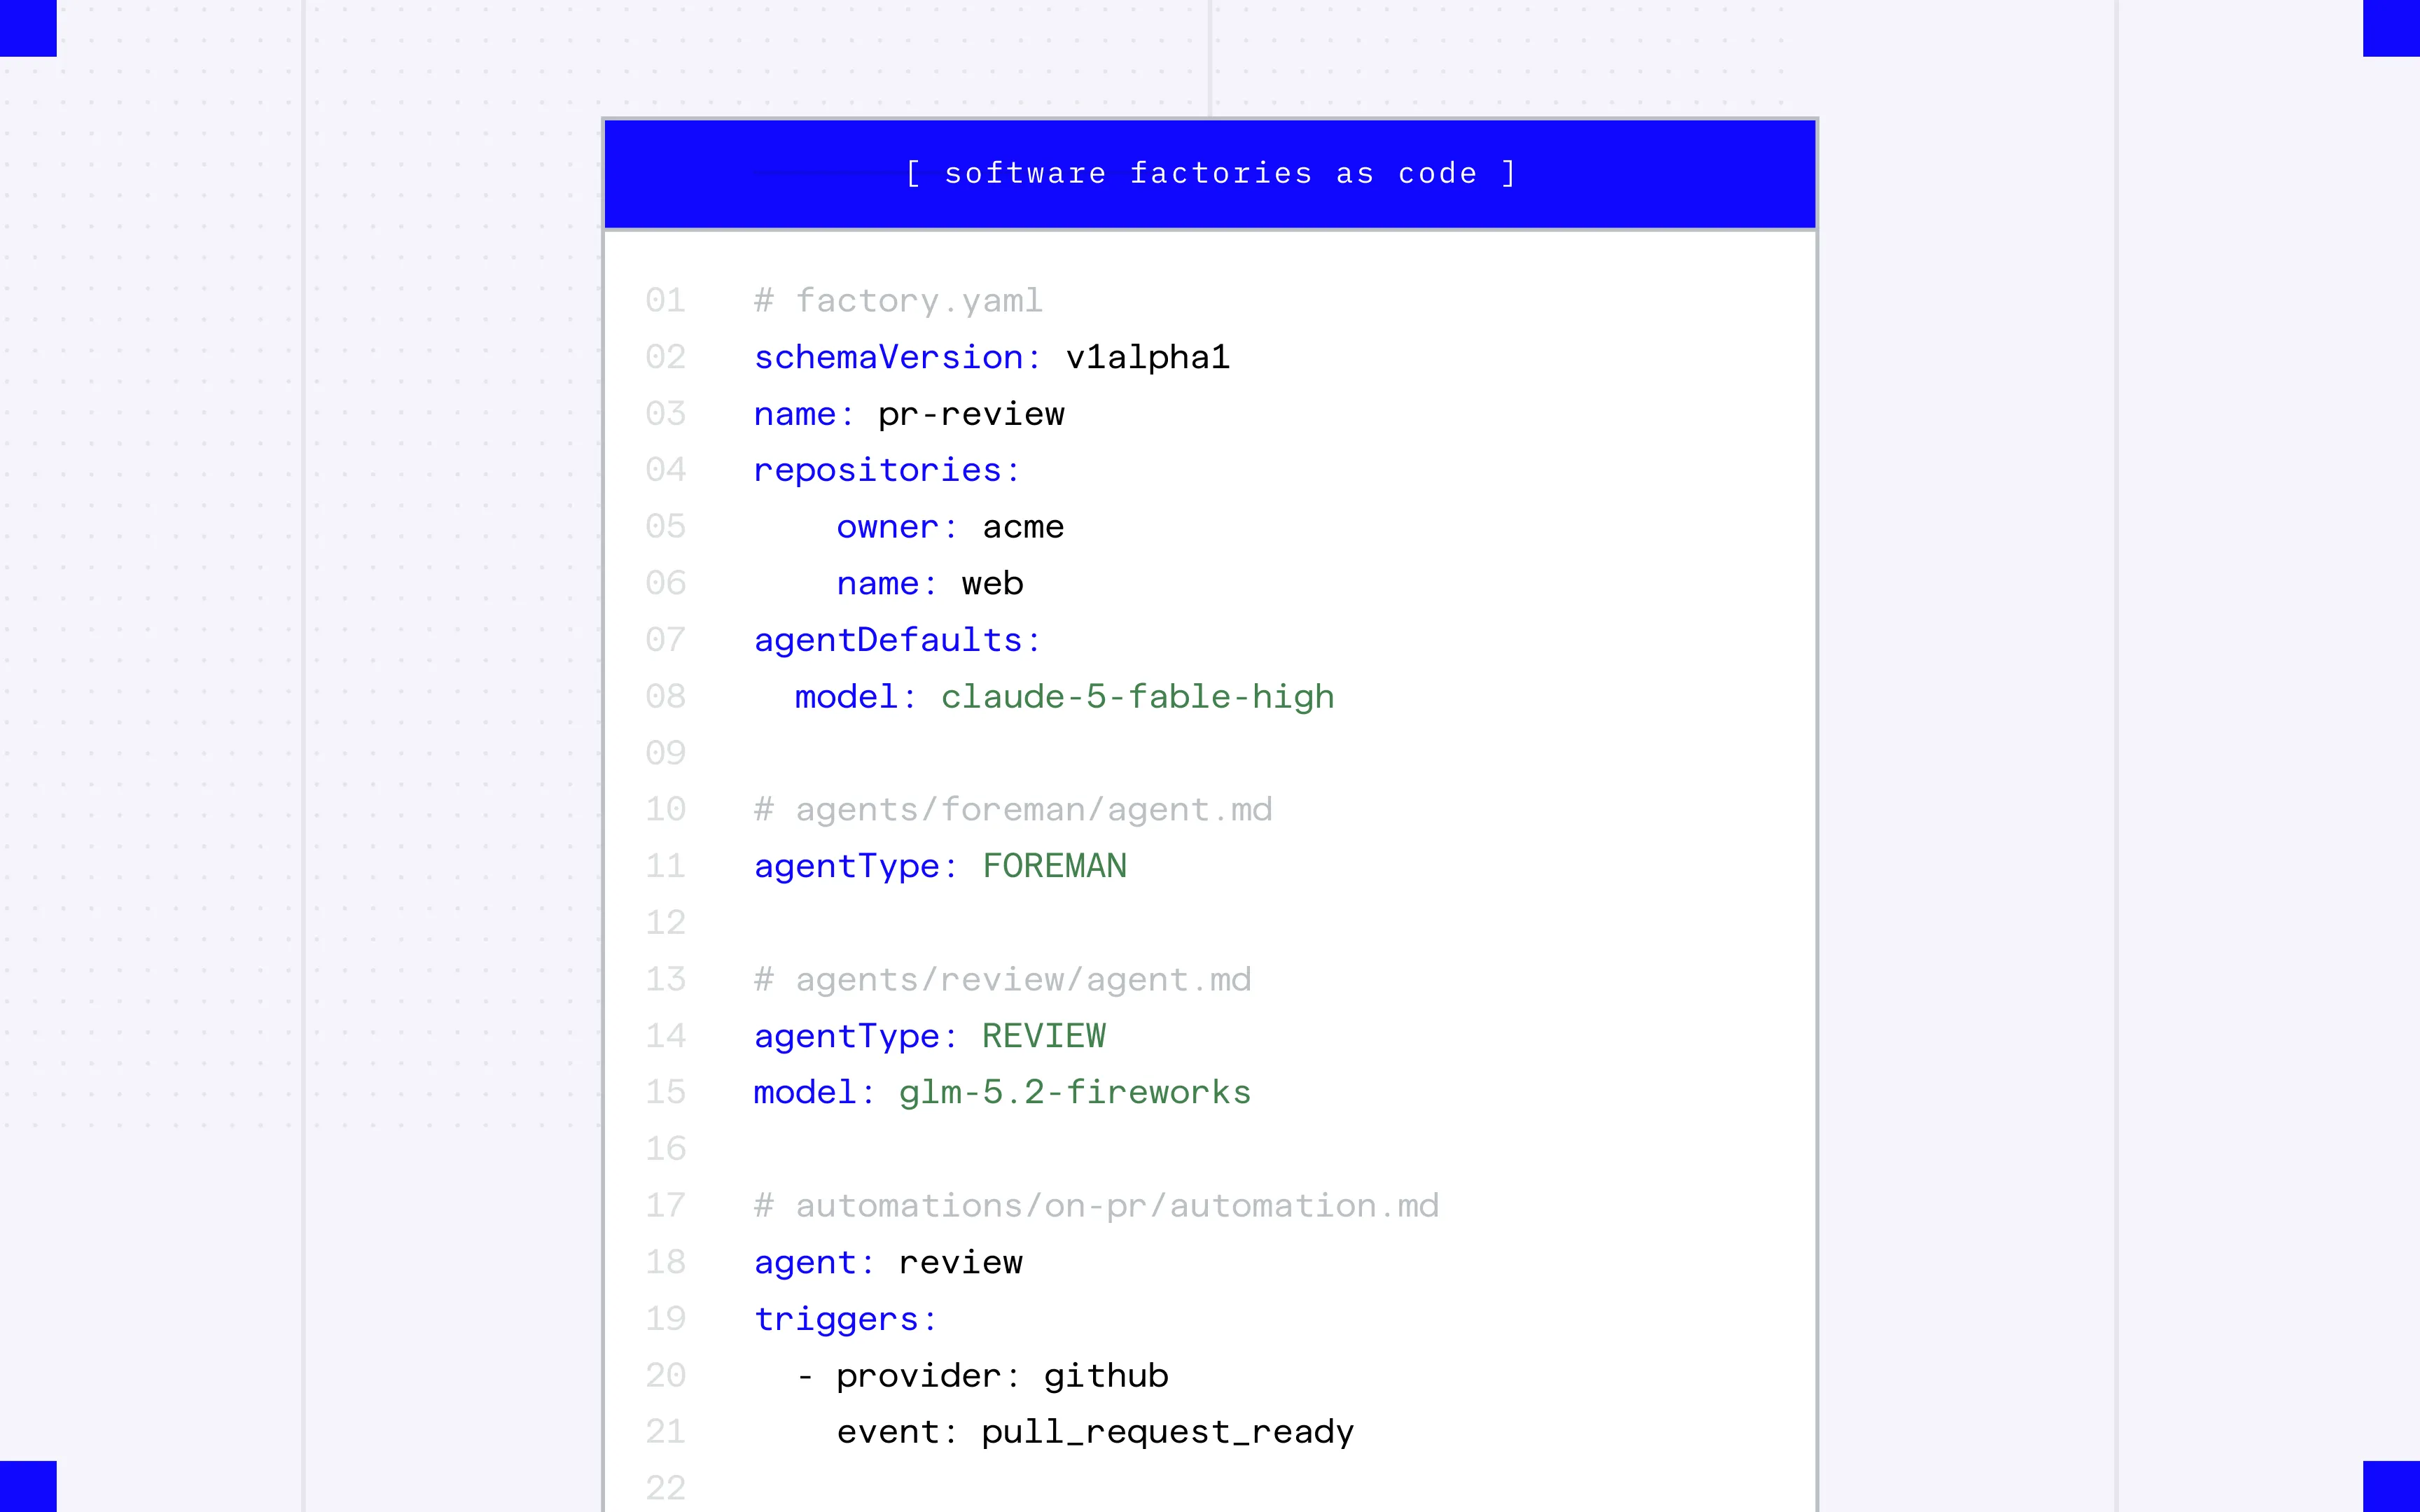
图 5:Warp 把仓库、默认模型、Agent 角色和 GitHub 触发器收进 factory.yaml,让 Factory 本身也能被 diff、review 和 rollback。来源:Warp, Introducing Warp Factories。
Warp 的 factory.yaml 把仓库、默认模型、Agent 角色和自动触发器写进版本控制;具体 Agent 再绑定自己的 instructions、Skills、MCP、权限和模型。这样修改 Reviewer 模型、收紧某个工具权限或增加一个触发器,都可以像基础设施变更一样 diff、review、canary 和 rollback。
它还明确区分 model 与 harness。一个便宜模型可以处理 triage,Claude Code 可以承担某类实现,Codex 可以运行另一类长任务,Warp Agent 则提供更广的模型路由。Factory MCP 让本地 Claude Code、Codex 或其他 MCP client 把任务推入云端 Factory,也能把云端任务拉回本地继续调试。
Warp 的另一条路线,是把 Factory 自身变成被评测的对象:
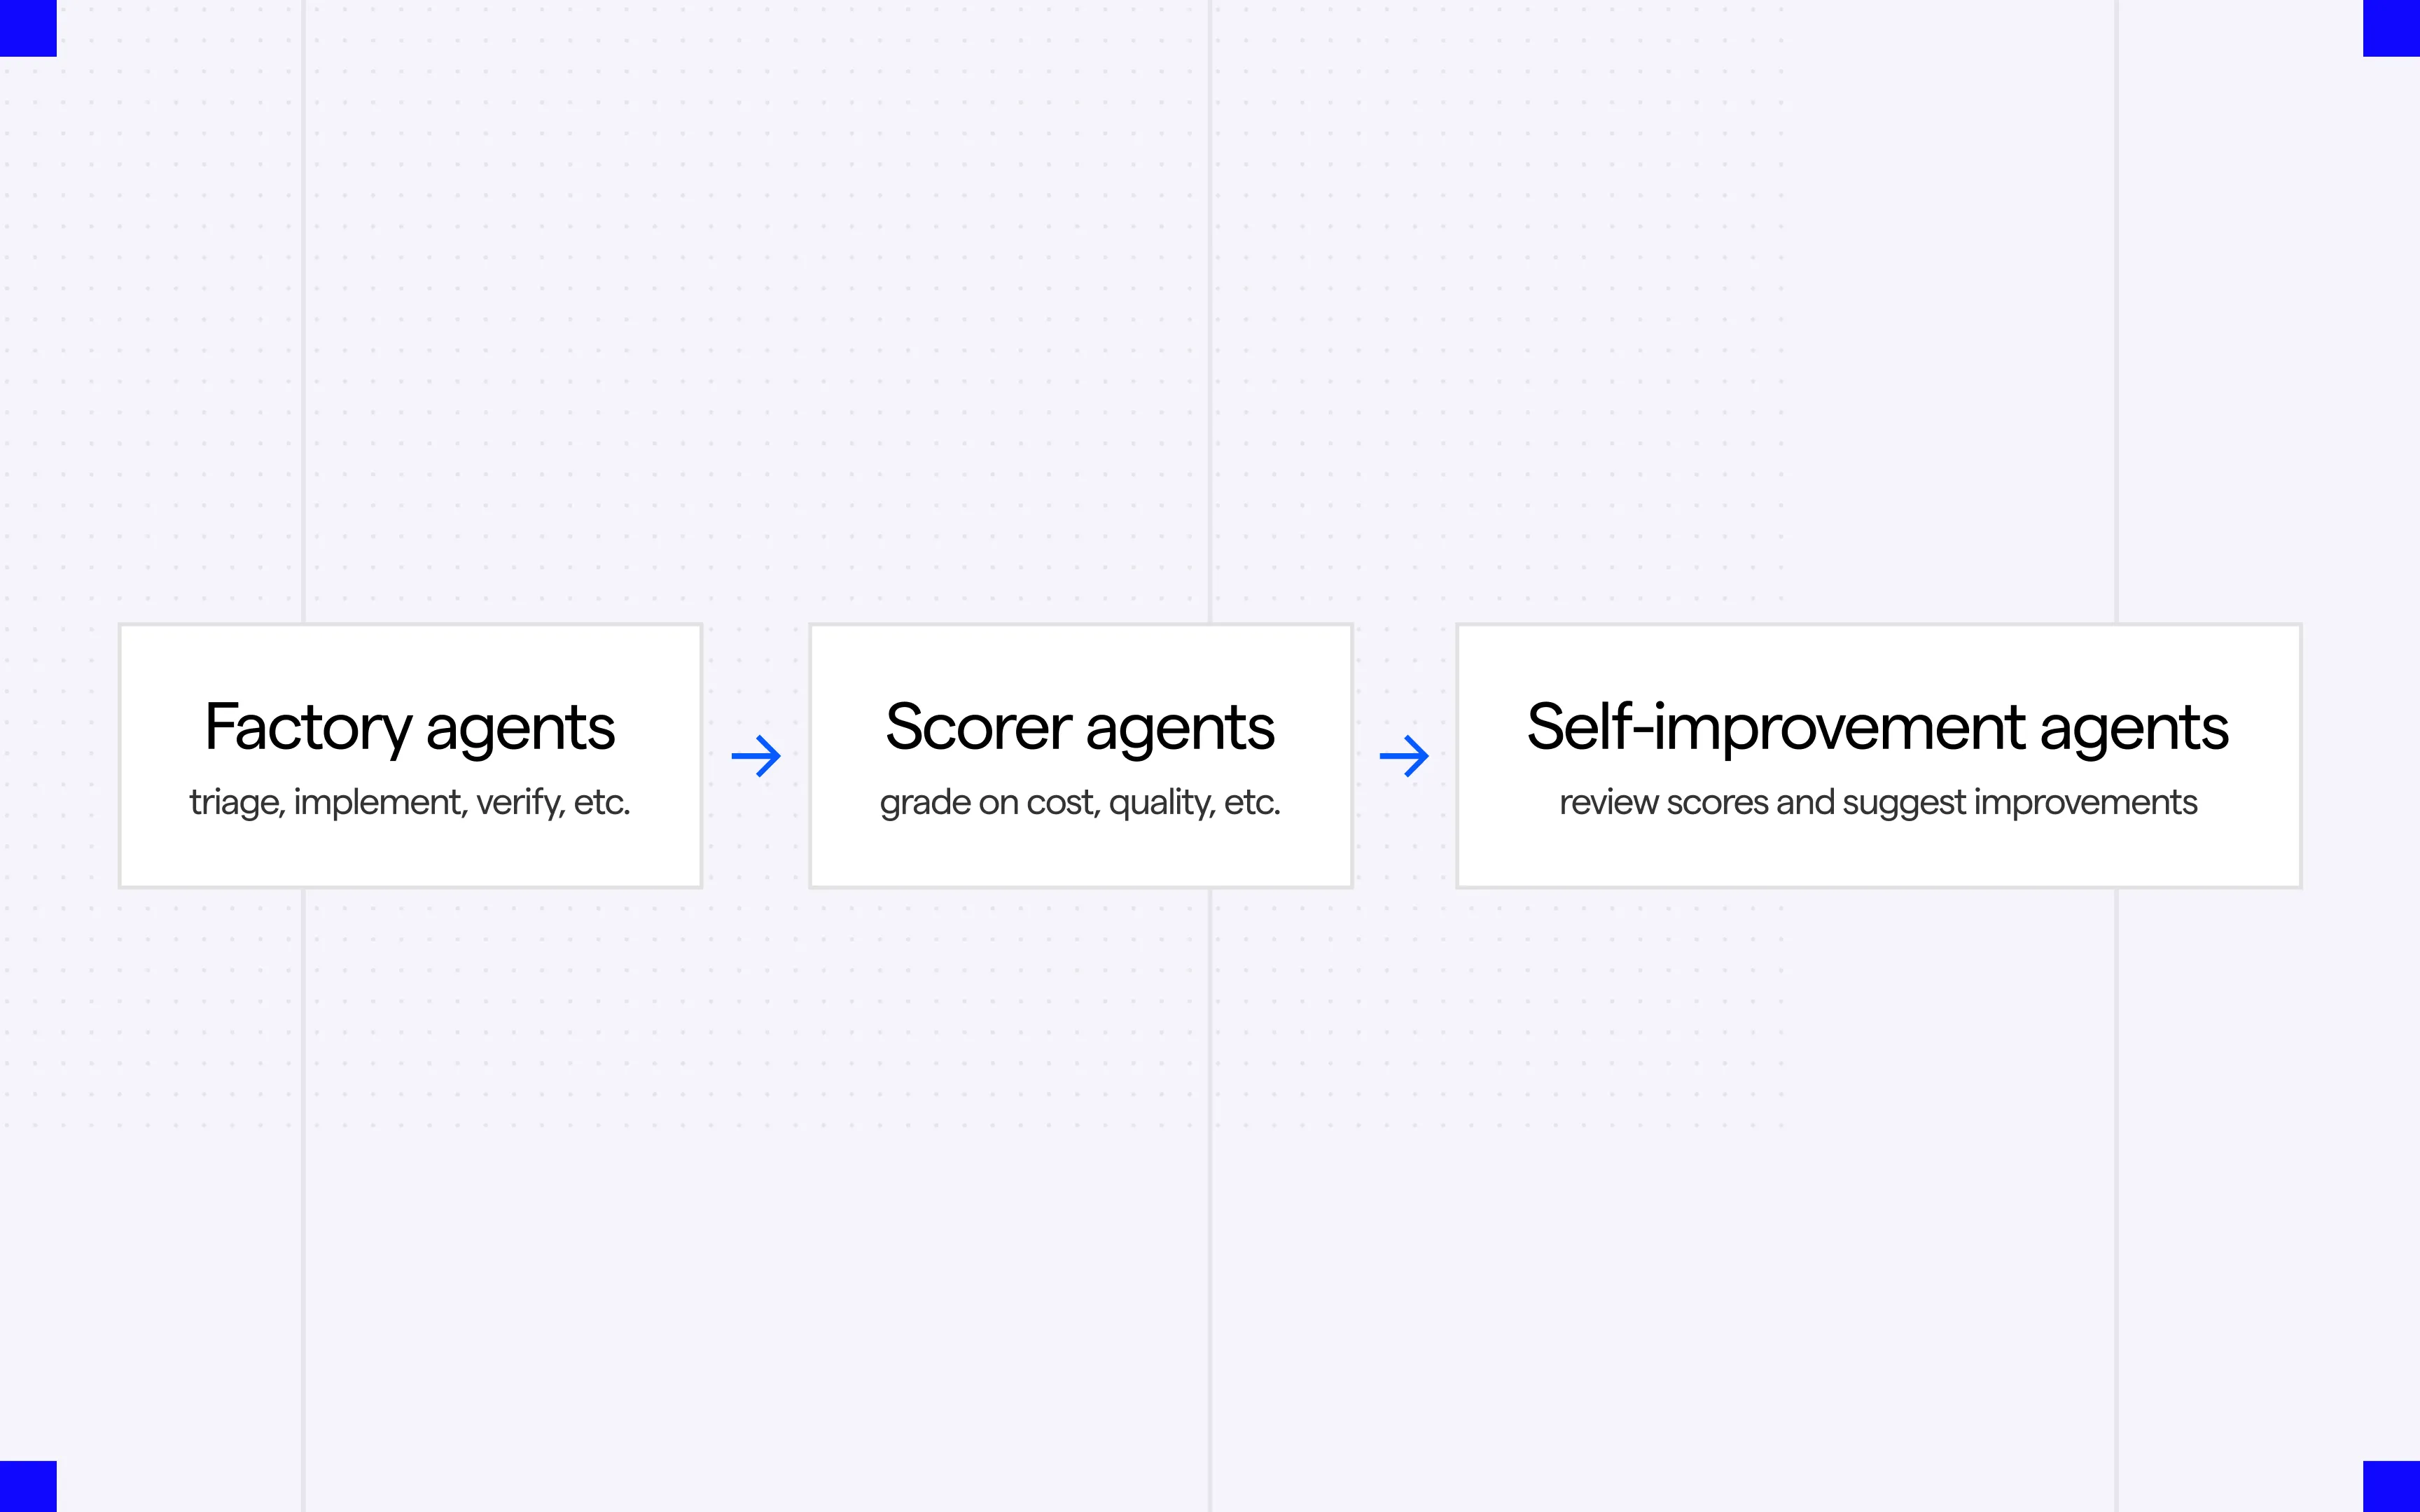
图 6:Warp 将执行 Agent、评分 Agent 和自改进 Agent 连成闭环:先从真实任务产生样本,再用 eval 驱动配置、Skill 和工具改进。来源:Warp, Closing the loop with self-improving cloud software factories。
Factory Agent 完成 triage、implementation 或 review;Scorer 按 task compliance、procedure、verbosity、efficiency 和 code quality 打分;Observer 汇总成本、质量和人工反馈;Improver 再提出对 model routing、prompt 或 Skill 的小幅修改。修改仍以 code diff 进入审核。
公开宣传里最容易略过两条边界。
第一,memory 不等于 skill。Memory 可以记录不断变化的上下文和运行经验,Skill 则是经过筛选、版本化并有 owner 的操作知识。把所有反馈自动写进 memory,不会自然得到更好的 Factory,反而可能积累互相矛盾的局部经验。
第二,自改进必须有回归任务集。一个 prompt 在最近十个 issue 上得分更高,不代表它在其他任务分布上没有退化。Warp 展示了 scorer、benchmark 和成本面板,但 Factories 仍处于有限开放阶段,公开材料不足以独立验证其质量指标和内部约 30% 自动化比例。
OpenAI:把 Issue Tracker 变成 Agent 控制面
OpenAI 的 Harness Engineering 解决“怎样让 Agent 在仓库里可靠工作”,Symphony 则解决“怎样不再由人盯着每个 Agent Session”。
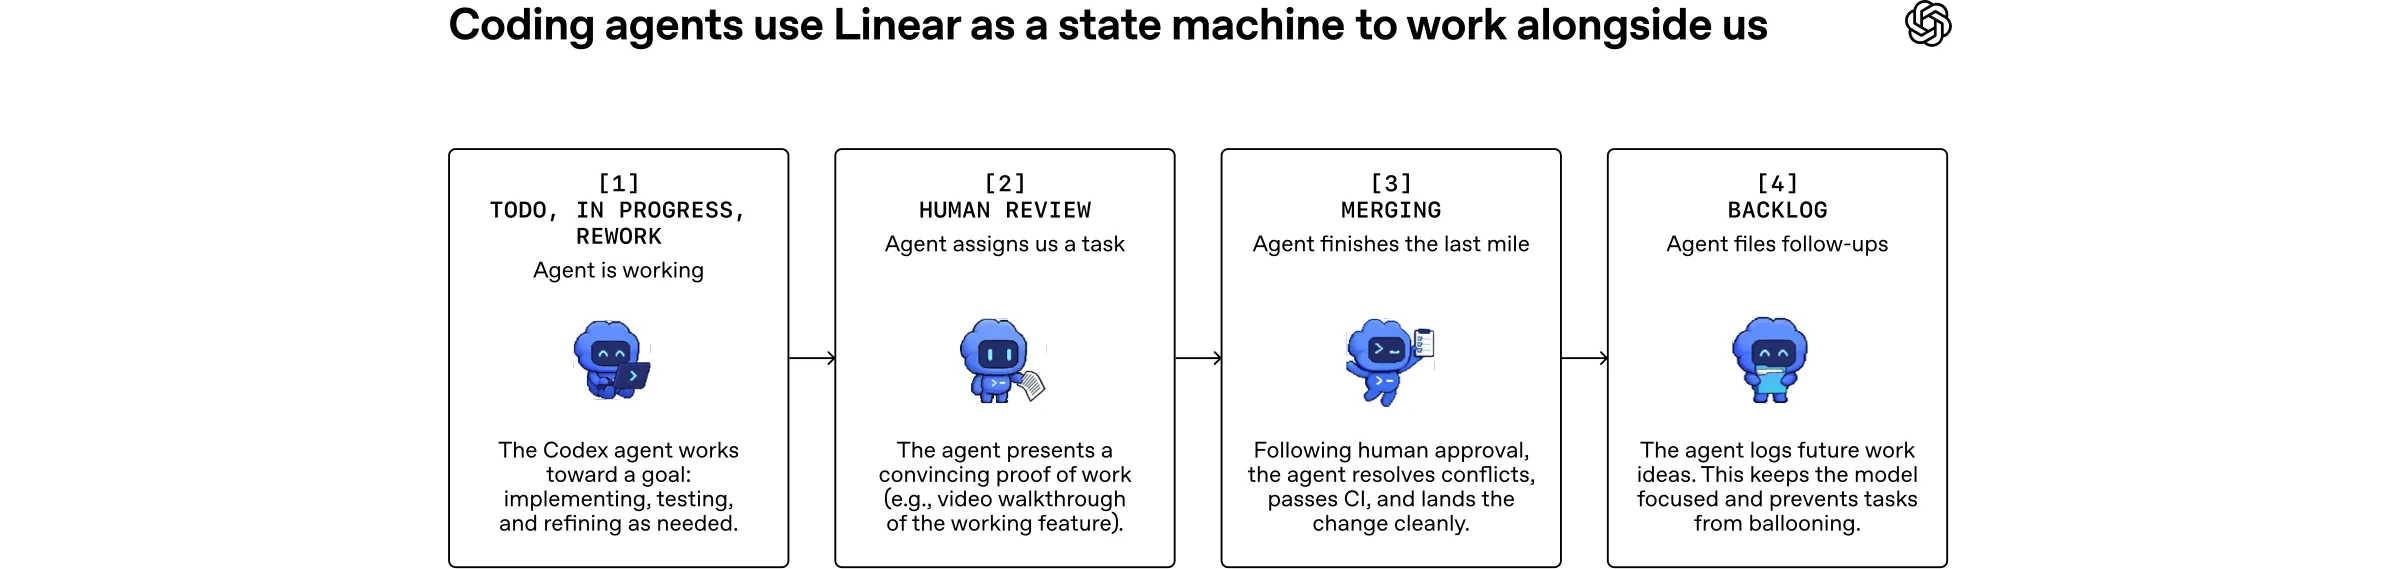
图 7:OpenAI Symphony 把 Linear issue 状态变成调度信号,驱动 Workspace 创建、Agent 运行、重试、人工审核和后续任务。来源:OpenAI, Symphony。
Symphony 出现之前,工程师会同时开几个 Codex Session,分派任务、查看进度、纠偏、处理 CI,再切到下一个窗口。OpenAI 称多数人管理三到五个并行 Session 后,context switching 就开始抵消 Agent 的速度。
Symphony 改变了工作单位:工程师管理 Linear issue,Orchestrator 管理 Session。一个 active issue 映射到独立 Workspace,后台服务持续 polling、claim、dispatch、reconcile;Agent 崩溃或 stalled 时,系统停止当前进程并按退避策略重试。Issue 状态变化后,Orchestrator 会停止已不再 eligible 的 Run;进入终态时再清理 Workspace。
公开的 SPEC.md 把下面几个对象拆得很清楚:
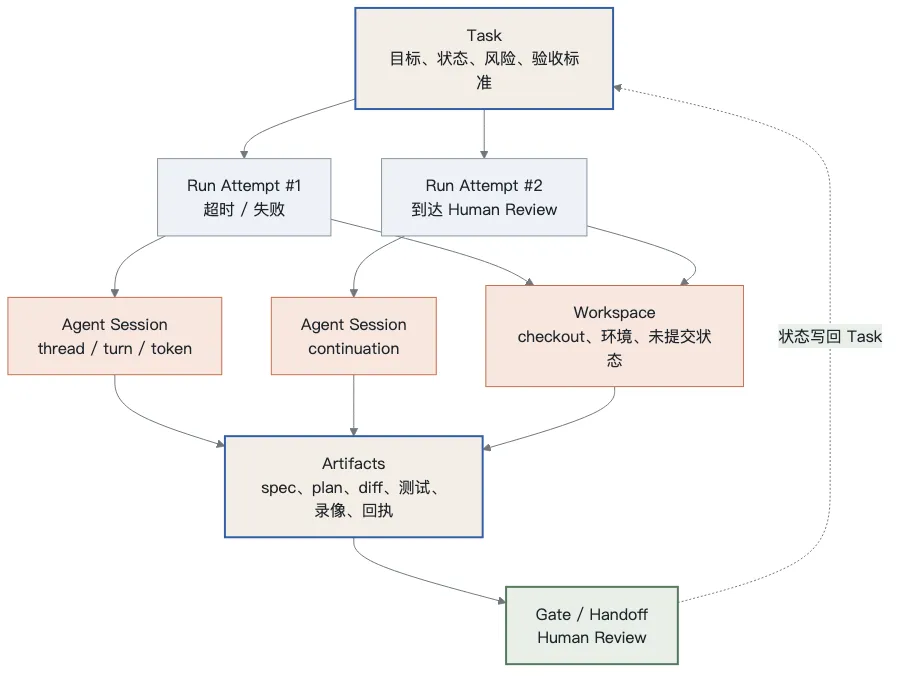
图 8:Task 保存持久目标与权威状态,Run Attempt、Agent Session 和 Workspace 记录具体执行,Artifact 则为 Gate 与 Handoff 提供可审核证据。
- Task / Issue:目标、优先级、依赖、当前阶段和验收要求;
- Run Attempt:针对 Task 的一次执行尝试,可以成功、失败或进入重试;
- Live Session:具体的 thread、turn、进程、最近事件与 token 统计;
- Workspace:该任务的文件系统和执行环境;
- Artifact:Spec、Plan、diff、测试、截图、录像和回执;
- Retry Entry:attempt、due time、error 和 timer;
- Orchestrator State:running、claimed、retry queue、并发上限和累计用量。
这组区分解决了一个常见误判:Agent 进程正常退出,不代表任务已经完成。 它可能只是把 issue 推到 Human Review;也可能完成了一次调查,创建了后续任务;甚至什么代码都没有生成。Task 的权威状态必须存在于 Session 之外。
Symphony 主动收窄了自己的责任:它不负责 rich UI、多租户、通用 DAG 引擎或统一审批策略。tracker write 往往由 Agent 通过工具完成,Orchestrator 只持有调度和恢复所需的最小状态。重启时,它从 tracker 与 Workspace 重建可恢复信息,并不声称精确恢复所有内存 scheduler state。
Symphony 还暴露了固定流水线的局限。OpenAI 早期只让 Agent “实现这个任务”,后来发现模型已经可以自己读取 review、拆多个 PR、处理 CI 和创建后续 issue,于是逐步从僵硬节点转向目标驱动:控制面负责边界、资源和状态,Agent 在边界内选择完成目标的路径。
四条路线汇成怎样的参考架构
把四家的实践叠在一起,一套 Software Factory 至少有九个相对独立的组件:
| 组件 | 职责 | 典型实现 |
|---|---|---|
| Intake Adapter | 接收 issue、intent、消息、告警 | GitHub webhook、Linear、Slack、Factory MCP |
| Task Control Plane | 保存权威状态、claim、依赖和 handoff | Linear state machine、Factory database |
| Workflow / Policy | 定义阶段、权限、模型、触发器 | factory.yaml、WORKFLOW.md、Hooks |
| Planner / Router | 澄清、分诊、拆解、选择执行路径 | Triage、Foreman、Classifier、Analyst |
| Agent Runtime / Harness | 运行模型、工具和上下文循环 | Claude Code、Codex app-server、Warp Agent |
| Workspace / Sandbox | 隔离文件、进程、网络和凭据 | Vercel Sandbox、worktree、Modal VM |
| Artifact Store | 保存 Spec、Plan、证据和交接材料 | Git、PR、Blob、issue comment |
| Verification / Gate | 测试、独立审核、人工批准 | CI、browser/computer use、Reviewer、policy |
| Observability / Eval | 成本、质量、重试、回归和流程改进 | traces、scorers、benchmark、DORA 指标 |
四家公司从不同部位切入这张图。Anthropic 从 artifact 与组织知识切入;Vercel 从开源维护工作流切入;Warp 从企业控制面和评测切入;OpenAI 从 Agent-friendly repo 与任务调度切入。
其他公开实践也能放回这九个组件里:
- Stripe Minions 强调 one-shot 端到端执行,官方称每周合并超过 1000 个由 Minion 编写的 PR;
- Ramp Inspect 强调完整上下文与 UI/telemetry 验证;
- Spotify Xirp 用独立 worktree 管理 50 多个并行 Session,并把组织上下文从具体 harness 中剥离;
- GitHub Agentic Workflows 把自然语言工作流编译成 hardened Actions,默认只读,写操作必须通过声明过的 safe outputs。
来源:Stripe · Ramp · Spotify · GitHub
Factory 仍然没有解决的几件事
错误的 Spec 会被更快放大
Agent 执行速度越快,前置定义越重要。模糊需求在交互式 Session 里可能被工程师边做边修正;进入无人值守流水线后,它会沿着错误方向一路生成代码、测试和 Review。因此,入口必须允许 clarify、reject premise 和 human judgment 成为一等状态,单纯换用更强的模型解决不了这个问题。
实现与验证可能共享同一个错误前提
让同一个 Agent 写实现、写测试、解释测试为什么通过,容易产生“共谋式验证”。分离上下文、让 Reviewer 读取实际 diff、使用不同模型或确定性检查,都只能降低相关性,不能彻底消除。对业务语义、视觉体验和跨服务行为,人类仍要设计更好的 oracle。
Review backlog 不会因为 Agent 增多自动消失
Factory 可以提前整理证据、缩小 diff、按风险路由,却不能无限扩展人类判断力。如果自动生成 PR 的速度超过团队吸收速度,系统只是把 backlog 从 issue 列表搬到了 review queue。
外部副作用需要比 Git 更强的恢复语义
Git branch 可以丢弃,数据库迁移、生产配置和外部 API 写操作未必可逆。超时后系统可能不知道动作有没有成功;盲目重试会产生重复副作用。Factory 需要 idempotency key、operation receipt、checkpoint 和 TOOL_OUTCOME_UNKNOWN 一类显式状态,而不是把所有异常折叠成 failed。
Factory 配置本身会漂移
Prompt、Skill、模型路由和权限一旦频繁变化,就成为新的软件供应链。配置要有 owner、版本、回滚、canary 和 regression eval;“让 Agent 自动优化自己”不能绕过这些工程纪律。
吞吐量不是产品价值
PR 数、issue 关闭率和成本/PR 都是有用的内部指标,却不足以证明软件变好了。GitHub 的 Agentic Engineering System 建议同时观察治理、共享知识与客户价值:如果 escaped defect、返工和稳定性恶化,交付速度上升只说明系统更快地产生了需要处理的变化。DORA 的 2025 研究也将 AI 描述为组织系统的放大器,而不是独立于工程基础的效率按钮。DORA
普通团队怎样开始
先挑一条低风险、可验证的流程,再补齐它所需的状态、环境和恢复语义。不要反过来先建一套多 Agent 平台,然后再寻找适合它的问题。
第一步:先让仓库对 Agent 可读
补齐真实的 build、test、lint 命令;将架构边界、常见错误和验收方法写进可发现的文档;让每个 worktree 能启动独立应用;把日志、浏览器和关键指标暴露给 Agent。没有这些基础,Orchestrator 只能规模化地启动缺少上下文的 Session。
第二步:只选一个可验证流程
Backport、dependency update、文档同步、issue triage、有稳定回归测试的低风险 bug 都适合作为第一条流水线。不要从跨仓库架构调整或生产数据库迁移开始。
第三步:先保存 artifact,再自动 handoff
要求每次运行交付 Spec、Plan、diff、测试结果和未解决事项。人工仍然启动下一阶段时,先验证这些材料是否真的减少了 Review 成本;有效后,再让 artifact 的接受事件自动触发后续阶段。
第四步:补上恢复,而不是只补成功路径
明确 Task、Run、Workspace 与 Session;加入 claim、并发上限、stall timeout、取消和指数退避;外部写操作使用幂等键和回执。Dashboard 可以晚一点,状态语义不能晚。
第五步:用一组真实任务评测 Factory
至少记录:
- 可审核结果的成功率,而不是进程正常退出率;
- 每个接受任务的总成本;
- 人工介入次数与等待时间;
- 一次通过率和修改轮数;
- 重试、放弃和结果未知的比例;
- 合并后的返工、回滚与 escaped defect;
- 从需求进入到用户真正获得价值的周期。
当失败开始重复出现,再把它变成工具、环境、Skill、Hook 或 eval。这个顺序比先追求“自我进化”更可靠。
Software Factory 还不是标准产品类别
Software Factory 尚未形成统一标准,产品边界也还在变化。
但四家实践已经给出一组共同的最小结构:任务状态存在于 Session 之外;执行发生在可控 Workspace;Spec、Plan、验证和回执成为持久 artifact;权限与人工 Gate 由运行时强制;失败进入恢复或改进;模型和 harness 则是可按任务替换的执行部件。
Vercel 展示了这套流程如何在高流量开源项目中承担真实工作;Warp 尝试把它产品化为企业控制面;OpenAI 把最小调度语义写成规范;Anthropic 提供了从 intent 到生产反馈的完整流程语言。这些实践还不足以支撑“自动经营复杂软件产品”,它们的价值在于把 AI Native 开发从个人使用技巧,推进到可以讨论组件、状态、权限、恢复和指标的系统设计。
对工程团队来说,下一步不一定是购买一座 Factory。更实际的问题是:在自己的开发流程里,哪些状态仍只存在于人的脑子里,哪些交接仍靠人盯着窗口,哪些验证仍是 Agent 的自我报告,哪些失败发生后什么也没有留下。
当这些缺口被写成可观察的状态、可执行的策略和可复核的证据,Software Factory 才从宣传词变成工程系统。
资料与延伸阅读
核心材料
- Anthropic:The AI-Native SDLC Playbook
- Anthropic / Warp:How Warp builds self-improving agents on Claude
- Vercel:Building a software factory for AI SDK
- Vercel Labs:eve Software Factory Template
- Warp:Introducing Warp Factories
- Warp:Closing the loop with self-improving cloud software factories
- OpenAI:Harness engineering
- OpenAI:Symphony
- OpenAI:Symphony SPEC.md