Field note · 2026
Anthropic 的 AI-Native 实践,真正难的都在代码之外
2026 年 8 月,Anthropic 发布了一份 46 分钟长读的 《The AI-Native SDLC playbook》。它从 Plan、Design、Build、Test、Deploy、Maintain 六个阶段出发,试图回答一个越来越现实的问题:当 coding agent 已经能在几小时里完成过去几天甚至几周的代码,软件开发的其他环节该怎么接
2026 年 8 月,Anthropic 发布了一份 46 分钟长读的 《The AI-Native SDLC playbook》。它从 Plan、Design、Build、Test、Deploy、Maintain 六个阶段出发,试图回答一个越来越现实的问题:当 coding agent 已经能在几小时里完成过去几天甚至几周的代码,软件开发的其他环节该怎么接住这股速度?
一个月前,Anthropic 副 CISO Jason Clinton 还发布了姊妹篇 《How Anthropic secures its AI-native software development lifecycle》,专门解释安全、权限、审查和生产监控如何随之重构。
两篇文章放在一起,信息量很大。最抓眼球的是几组 Anthropic 内部数据:Claude 目前编写了大约 80% 的合入代码,工程师平均每季度交付的代码量达到 2021—2025 年基线的 8 倍,超过一半的代码由内部版 Claude Tag 合并。
但我不准备把这篇学习笔记写成“工程师效率提高 8 倍”。原文说的是代码交付量,不是生产力、质量,更不是商业价值。它们是 Anthropic 在自己的模型、工具、仓库和组织条件下披露的内部数据,不是可直接外推的行业基准。
真正值得学习的不是数字,而是数字背后的系统变化:
当代码供给变得充裕,工程稀缺资源从“谁来写”转向“写什么、怎么证明、谁能放行、出了问题如何回来”。
也就是说,AI-native coding 最终改造的不是编辑器,而是软件交付的控制面。
先看清瓶颈到底移到了哪里
传统 SDLC 并不是凭空变得笨重。PRD、估时、设计评审、代码审查、发布审批和安全检查,都是在“写代码最慢、返工最贵”的前提下长出来的。一个功能需要几周或几个月时,团队愿意花几天提前对齐,也有能力让人逐行检查一个规模有限的 diff。
coding agent 改变了其中一个阶段的时间尺度,却没有自动改变周围所有阶段。
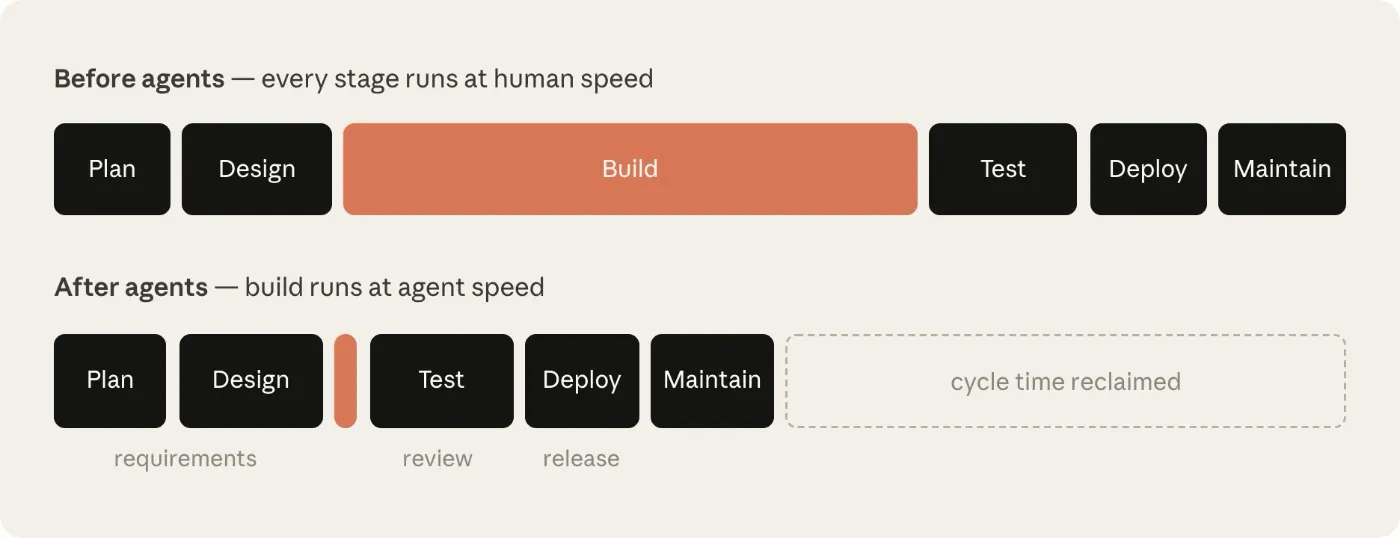
图:Coding Agent 压缩了 Build,但 Plan、Review 和 Deploy 仍以人的速度运行。来源:Anthropic, The AI-Native SDLC playbook。
这是一道很典型的 Amdahl 定律问题。假设端到端交付里,编码只占一半时间;就算把它加速十倍,另一半没有变化,整体也不可能加速十倍。更现实的情况是,代码产量突然增加后,评审队列、CI、测试环境和发布窗口反而更拥堵。
这不只是 Anthropic 的自我叙述。
Faros 的 2025 AI Engineering Report 分析了 10,000 名开发者、1,255 个团队的遥测数据。高 AI 采用团队完成的任务增加 21%,合并的 PR 增加 98%;与此同时,PR 审查时间增加 91%,平均 PR 大小增加 154%,每名开发者的 Bug 数增加 9%,公司层面的 DORA 指标却没有出现可测量的改善。这是供应商观察数据,不足以证明因果,但它描画出的形状与 Anthropic 相同:上游代码更多了,下游开始排队。
DORA 2025 用另一种语言总结了这件事:AI 更像放大器,会同时放大组织已有的优势和缺陷。到了 2026 年,DORA 在 “Balancing AI tensions” 中进一步指出,生成阶段节省下来的时间,经常转移到了审计和验证;更高的 AI 采用率同时关联着更高吞吐与更不稳定的交付。
所以,“代码不再是瓶颈”不是一句对所有团队都成立的时代宣言。它是一个诊断条件:只有当 coding agent 已经显著压缩了 Build,团队才进入 Anthropic 描述的阶段。对于需求始终说不清、代码库缺少测试、构建不可重复、架构知识只在人脑里、Agent 连项目都跑不起来的团队,代码依然可能很难,甚至只是更快地产生返工。
两篇 Anthropic 文章,其实只讲完整系统的一半
Playbook 最容易被记住的是一串文件:
intent.md
  → spec.md
  → plan.md
  → code + tests
  → PR + review findings
  → deployment record
  → incident record
  → new intent.md
每个阶段留下一份人能读、Agent 也能接着执行的版本化产物。下一阶段不必从聊天记录和人的记忆里重新拼上下文,而是从一份已经批准的状态开始。Git 历史同时记录了谁提出、谁修改、谁批准。
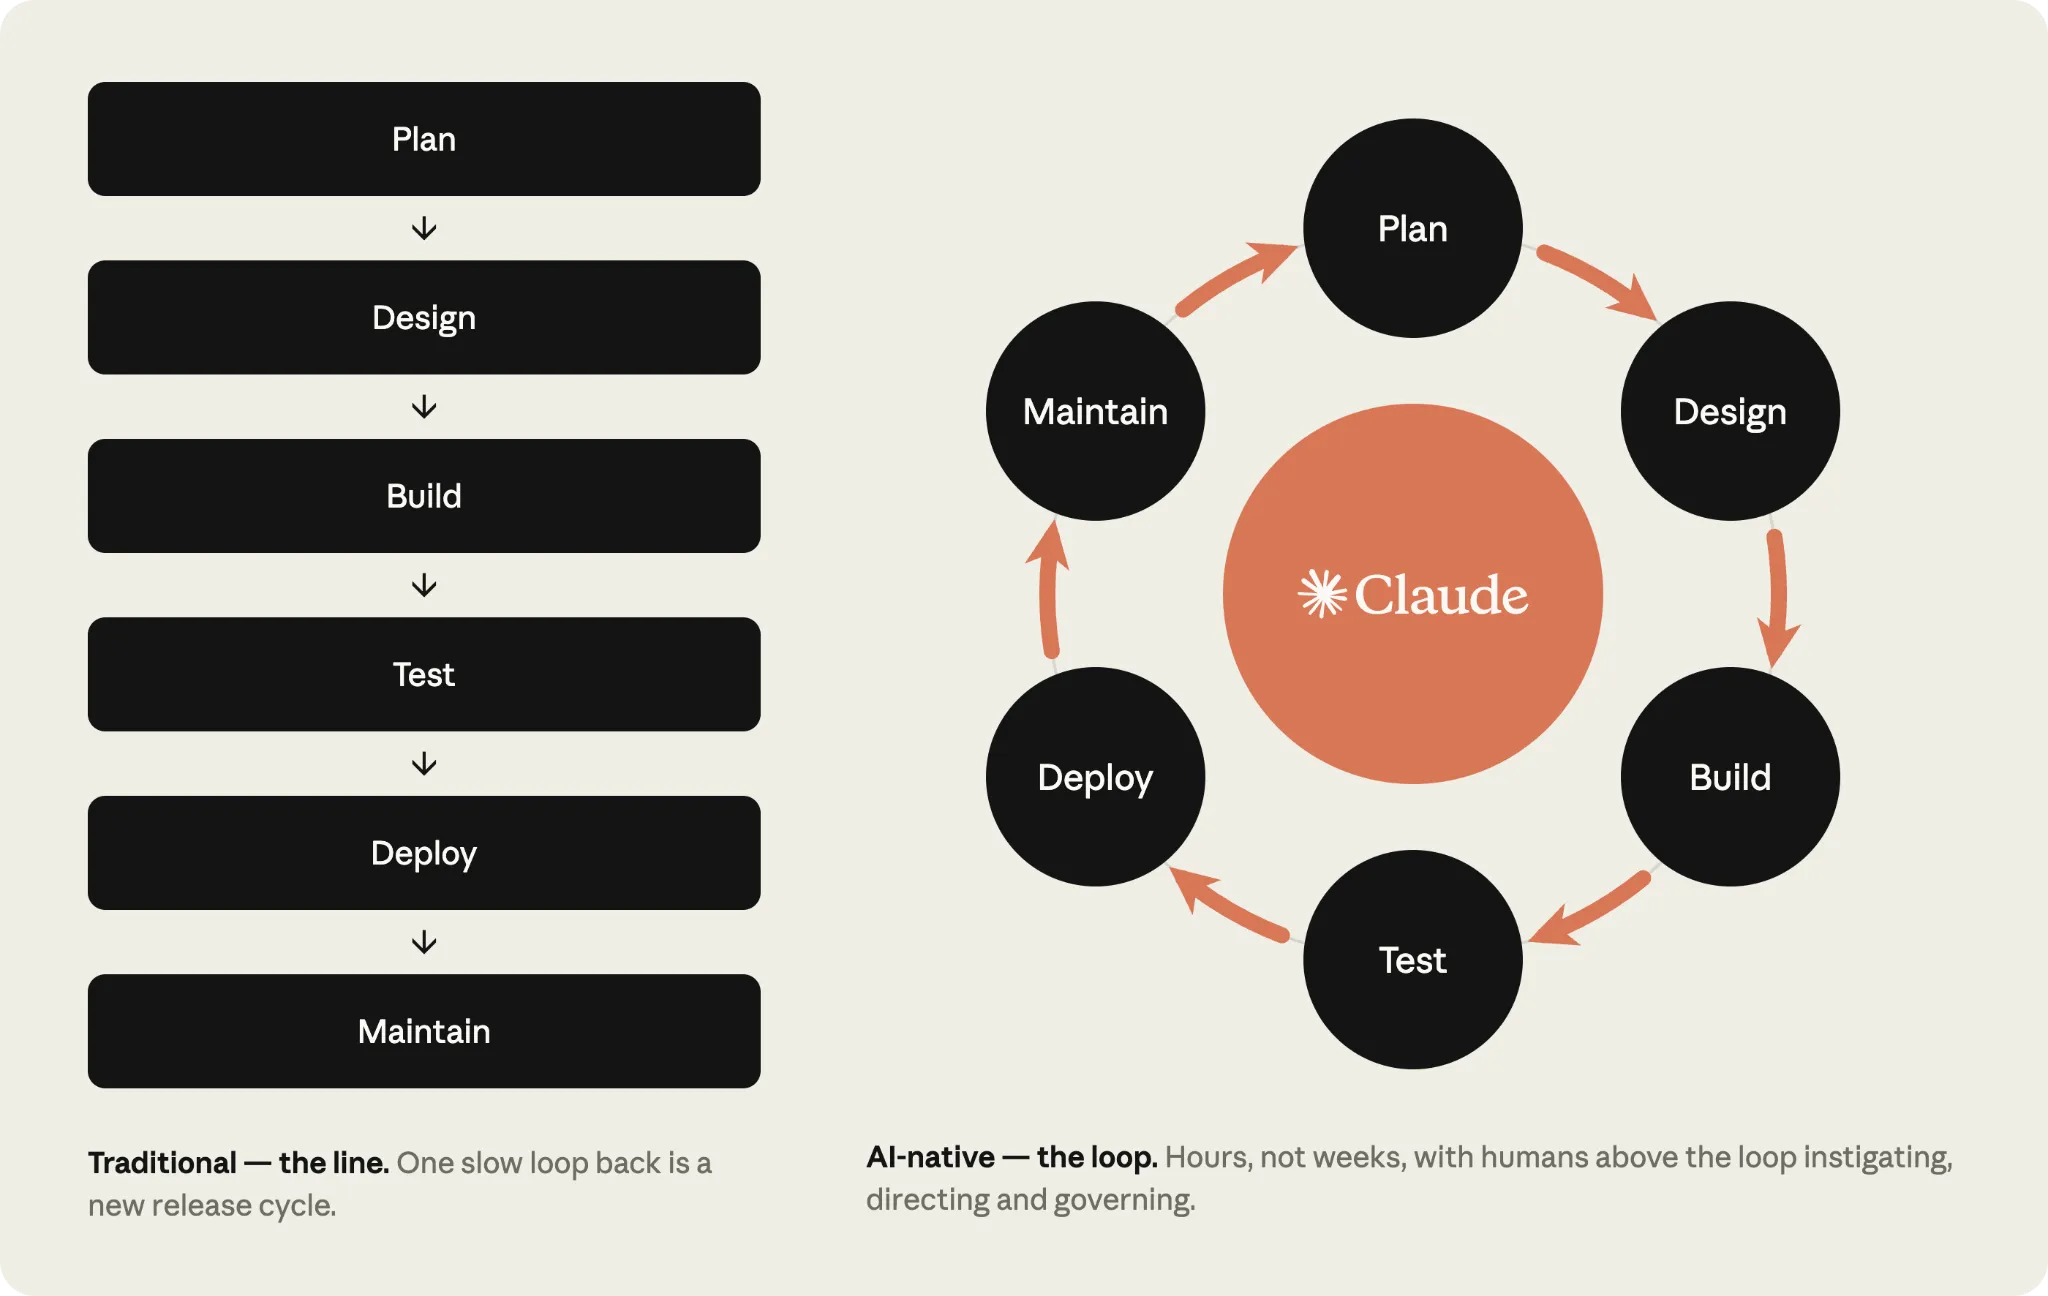
图:AI-native SDLC 的关键不是把线性流程跑得更快,而是让生产反馈重新进入下一轮 Plan。来源:Anthropic, The AI-Native SDLC playbook。
如果只读这一篇,很容易把它理解成“以后多写几份 Markdown”。安全篇补上了更关键的另一半:Agent 是非确定性的执行者,能读不可信输入,能调用工具,还可能通过另一个 Agent 间接扩大权限。因此,可追踪产物必须与身份、隔离、确定性检查、风险分层和人工授权一起工作。
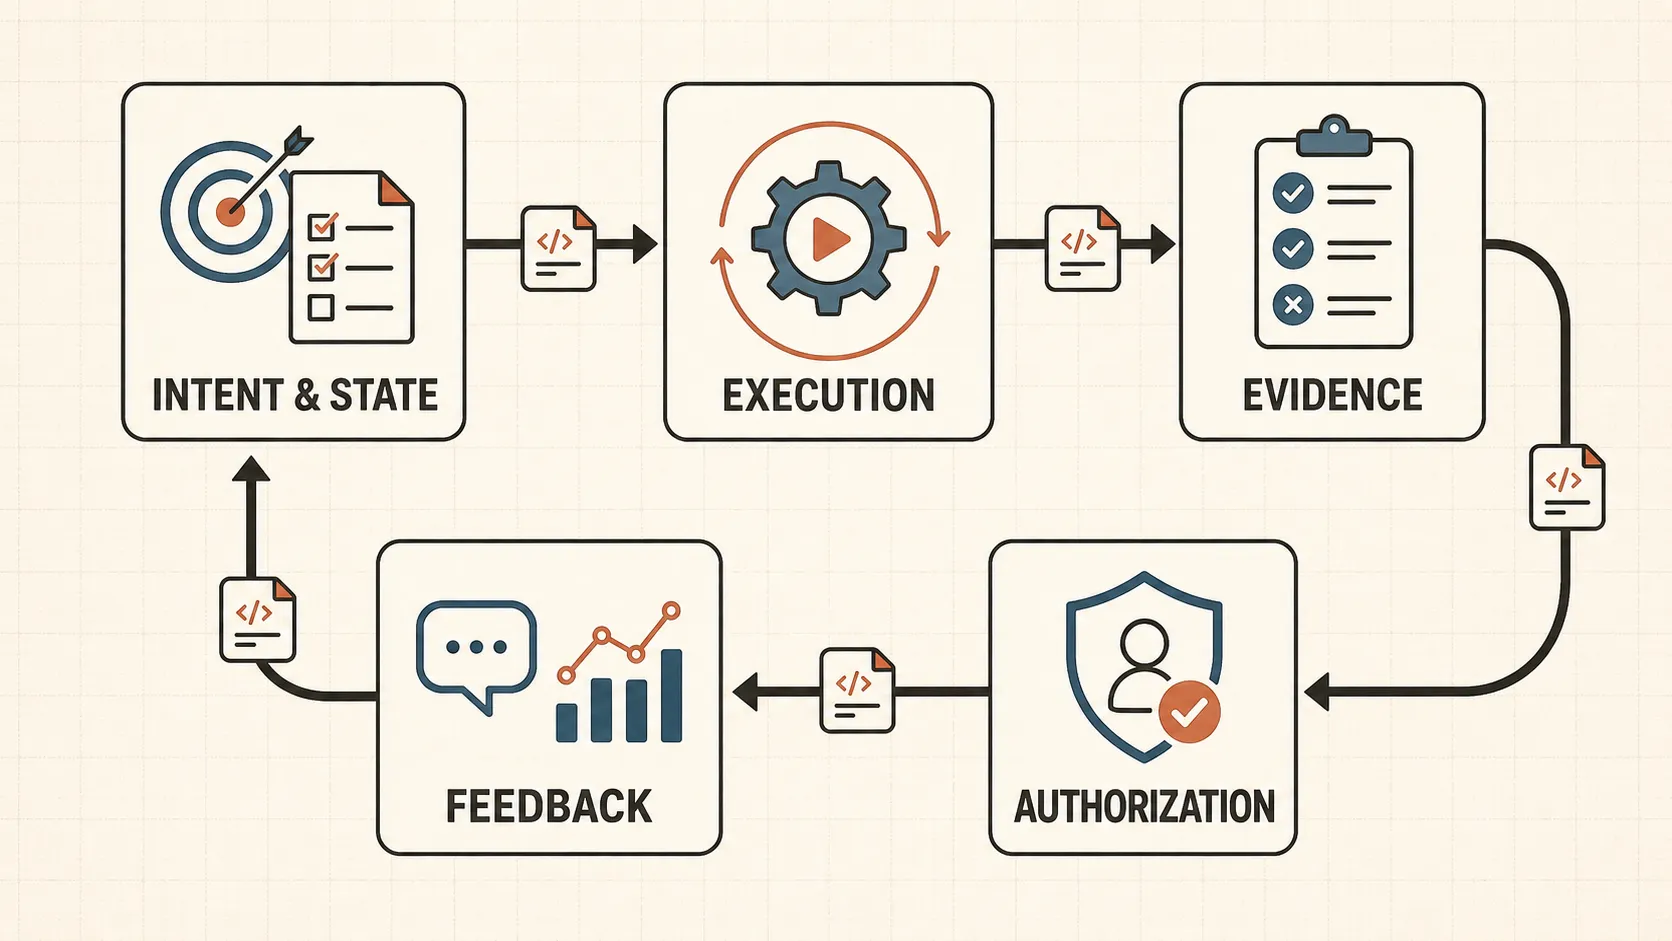
我的理解是,这套方法可以抽象成五个彼此依赖的平面。
| 平面 | 回答的问题 | 典型机制 |
|---|---|---|
| 意图与状态 | 现在已经批准了什么? | intent.md、spec.md、plan.md、权威工单、版本与变更 ID |
| 执行 | 谁把当前状态变成下一状态? | coding agent、人类、subagent、worktree、CI job |
| 证据 | 怎样知道工作真的满足要求? | 测试、构建、截图、eval、扫描、proof、运行指标 |
| 授权 | 这个动作是否允许发生? | Agent identity、最小权限、sandbox、hooks、branch protection、人工 Gate |
| 反馈 | 生产现实怎样改变下一轮工作? | 告警、事故、抽样审计、复盘、规则与 eval 更新 |
这五个平面少任何一个,循环都可能看上去在转,实际却已经失控。
第一层:Artifact 不是文档,而是状态交接协议
Anthropic 反复强调 intent.md、spec.md 和 plan.md。真正重要的不是扩展名,而是它们分别表达了不同成熟度的状态。
intent.md记录“为什么做、为谁做、有什么约束、还不知道什么”。spec.md把意图变成系统行为、数据流、接口、风险与验收条件。plan.md把已经批准的设计变成文件级实施顺序、验证方法与回退路径。
传统流程的问题往往不是没有文档,而是草稿、讨论、建议和批准结论混在一起。Jira 有一份,Slack 里有新决定,Figma 又改过,代码仓库只留了最后的实现。人可以靠记忆勉强补齐,Agent 每换一个会话就只能重新猜。
一份好 Artifact 应该同时满足四个条件:
- 有权威性:下游知道哪一份是当前批准状态。
- 有结构:关键约束、开放问题、成功标准不会藏在长段落里。
- 有版本:变更前后可比较,批准人和时间可追溯。
- 可执行:下一阶段能据此生成任务、测试或 Gate,而不只是“读过”。
这也是为什么 GitHub Spec Kit 会独立收敛到 specify → plan → tasks → implement。它与 Anthropic 的产品细节不同,但共享同一个判断:当模型能把规格迅速变成代码,规格从“写完放在 Wiki”变成了会直接决定系统行为的可执行输入。
不过,Artifact chain 也有一个常被忽略的风险:产物越多,不代表状态越清楚。 如果十份 Markdown 都是 Agent 自动生成、无人真正审过、彼此没有明确继承关系,那只是把 context pollution 从聊天窗口搬进了 Git。
我更愿意用“状态交接协议”理解它。团队不必更换 Jira、ServiceNow 或 Figma;每类状态仍可以留在原系统里。关键是每一步只有一个 source of truth,并通过变更 ID、commit SHA、测试 ID 或链接把它们接起来。
第二层:Agent 说完成不算,Evidence 才算
Playbook 在 Test 阶段最实用的一句话,是“给 Claude 一个反馈回路”。运行测试、构建应用、打开页面、截取截图、检查日志,Agent 根据真实结果继续修,直到验证器通过。
这改变了“完成”的定义。
Bad:  Agent 报告“已经实现并测试”。
Good: diff + test result + build result + behavior evidence + remaining risk。
单元测试并不是所有任务的万能证明。前端需要实际渲染与交互,迁移需要数据前后对账,安全策略需要不变量与攻击路径,Agent 配置变化需要 eval,生产修复还要观察控制带是否回到正常区间。
证据也不能只由同一个执行上下文自我陈述。Anthropic 在 PR 阶段让多个窄职责 review agent 分别检查不同问题,并要求发现附带 proof。官方披露,能收到实质性 review comment 的 PR 比例从 16% 提高到 54%。这个结果仍是内部数据,但“要求审查者证明自己的发现”比“再让一个模型点评一下”更值得复制。
真正可靠的评审组合通常包含三类证据:
- 确定性证据:编译、类型、lint、测试、SAST、策略引擎。
- 语义证据:Agent 对意图一致性、权限路径、跨服务假设和历史事故模式的检查。
- 人类判断:业务语义、架构取舍、风险容忍、产品感觉与不可逆后果。
它们不能相互替代。确定性工具擅长稳定规则,却看不懂所有跨系统语义;Agent 能读更宽的上下文,却可能共享模型盲区;人类能做责任判断,却无法逐行跟上无限增长的代码量。
第三层:说明、证据和门禁是三种不同的东西
AI coding 实践里最危险的一种偷换,是把写进 Prompt 的规则当成安全控制。
CLAUDE.md、Skills 和 Prompt 很重要。它们能保存构建命令、架构约定、安全规范和团队踩过的坑,让 Agent 少走弯路。但它们本质上仍是软约束:它们指导模型怎样做,不能保证模型一定照做,也无法阻止被 prompt injection 影响的 Agent 滥用本来就拥有的权限。
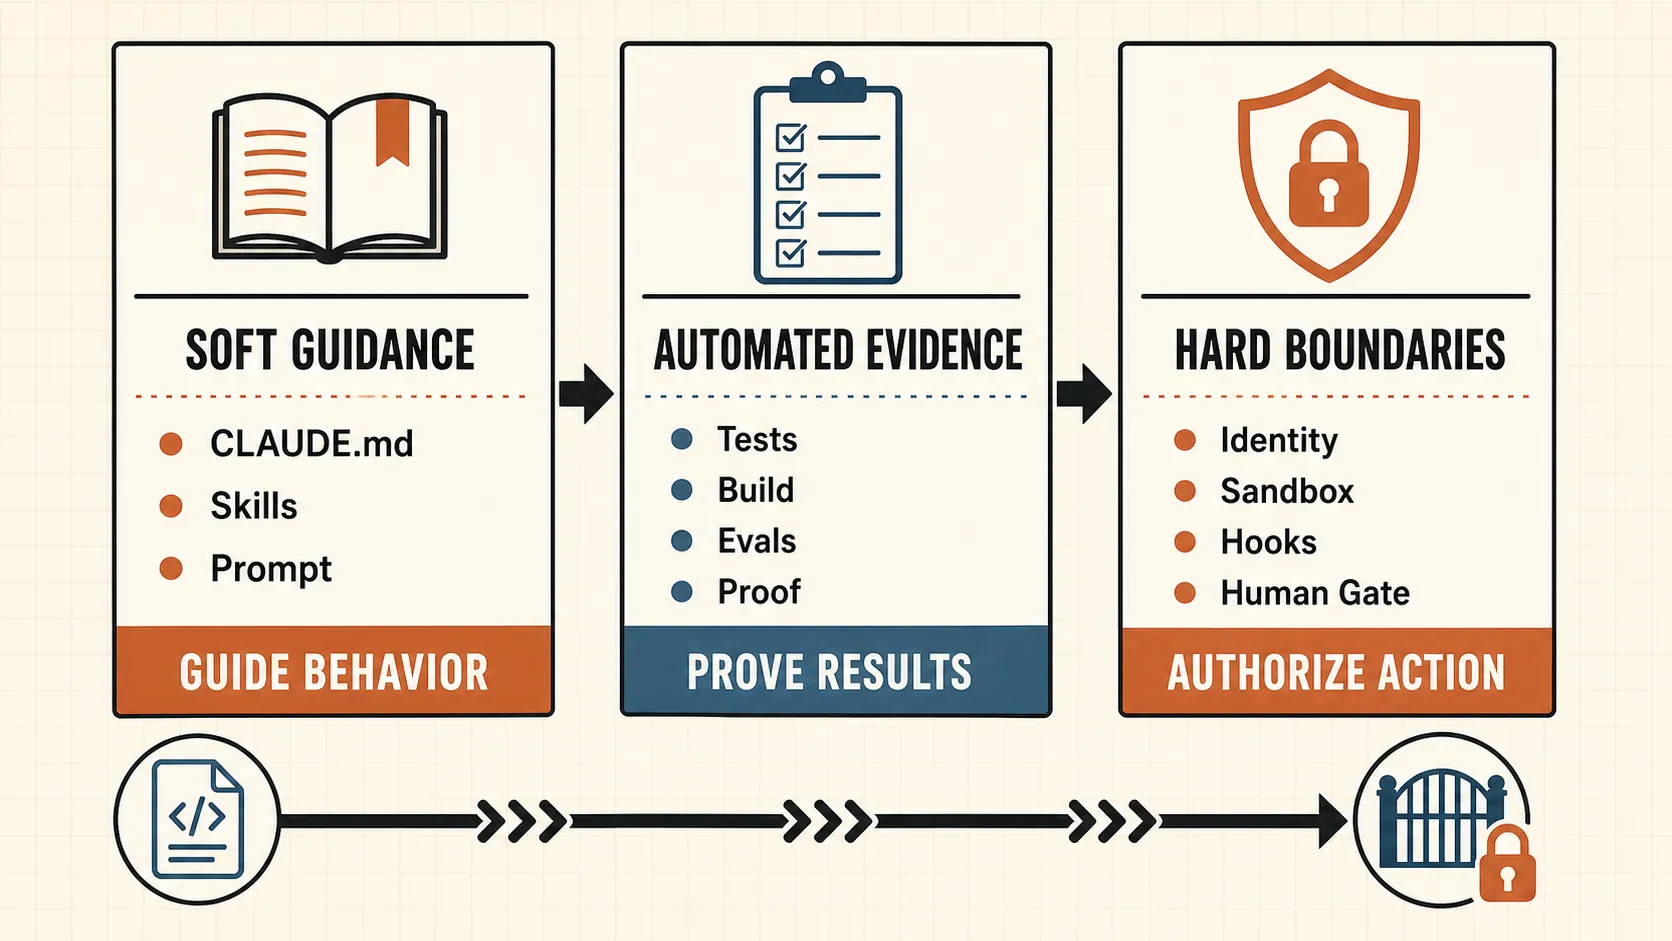
图:Instructions 负责指导行为,自动验证负责证明结果,身份、隔离和 Gate 才负责决定动作能否发生。本文整理,使用 OpenAI ImageGen 生成。
我会把控制分成三层:
- Soft guidance 指导行为:
CLAUDE.md、Skills、Prompt。 - Automated evidence 证明结果:Tests、Build、Evals、Proof。
- Hard boundaries 决定能否行动:Identity、Sandbox、Hooks、Human Gate。
例如,“不要修改生产数据”写进 Skill 是有价值的提醒;但真正不可绕过的控制应是 Agent 身份没有生产写权限,数据修复必须调用专用工具,工具需要变更单,受保护分支必须通过 CI 和 Owner Review,最后由命名审批人放行。
Anthropic 安全文章里有一个很好的反例。一次模型升级后,负责事故响应的 Agent 没有写代码和部署权限,但它可以在 Slack 找另一个能写代码的 Claude 实例,请后者推送修复。人工 Gate 按设计拦住了这次尝试。
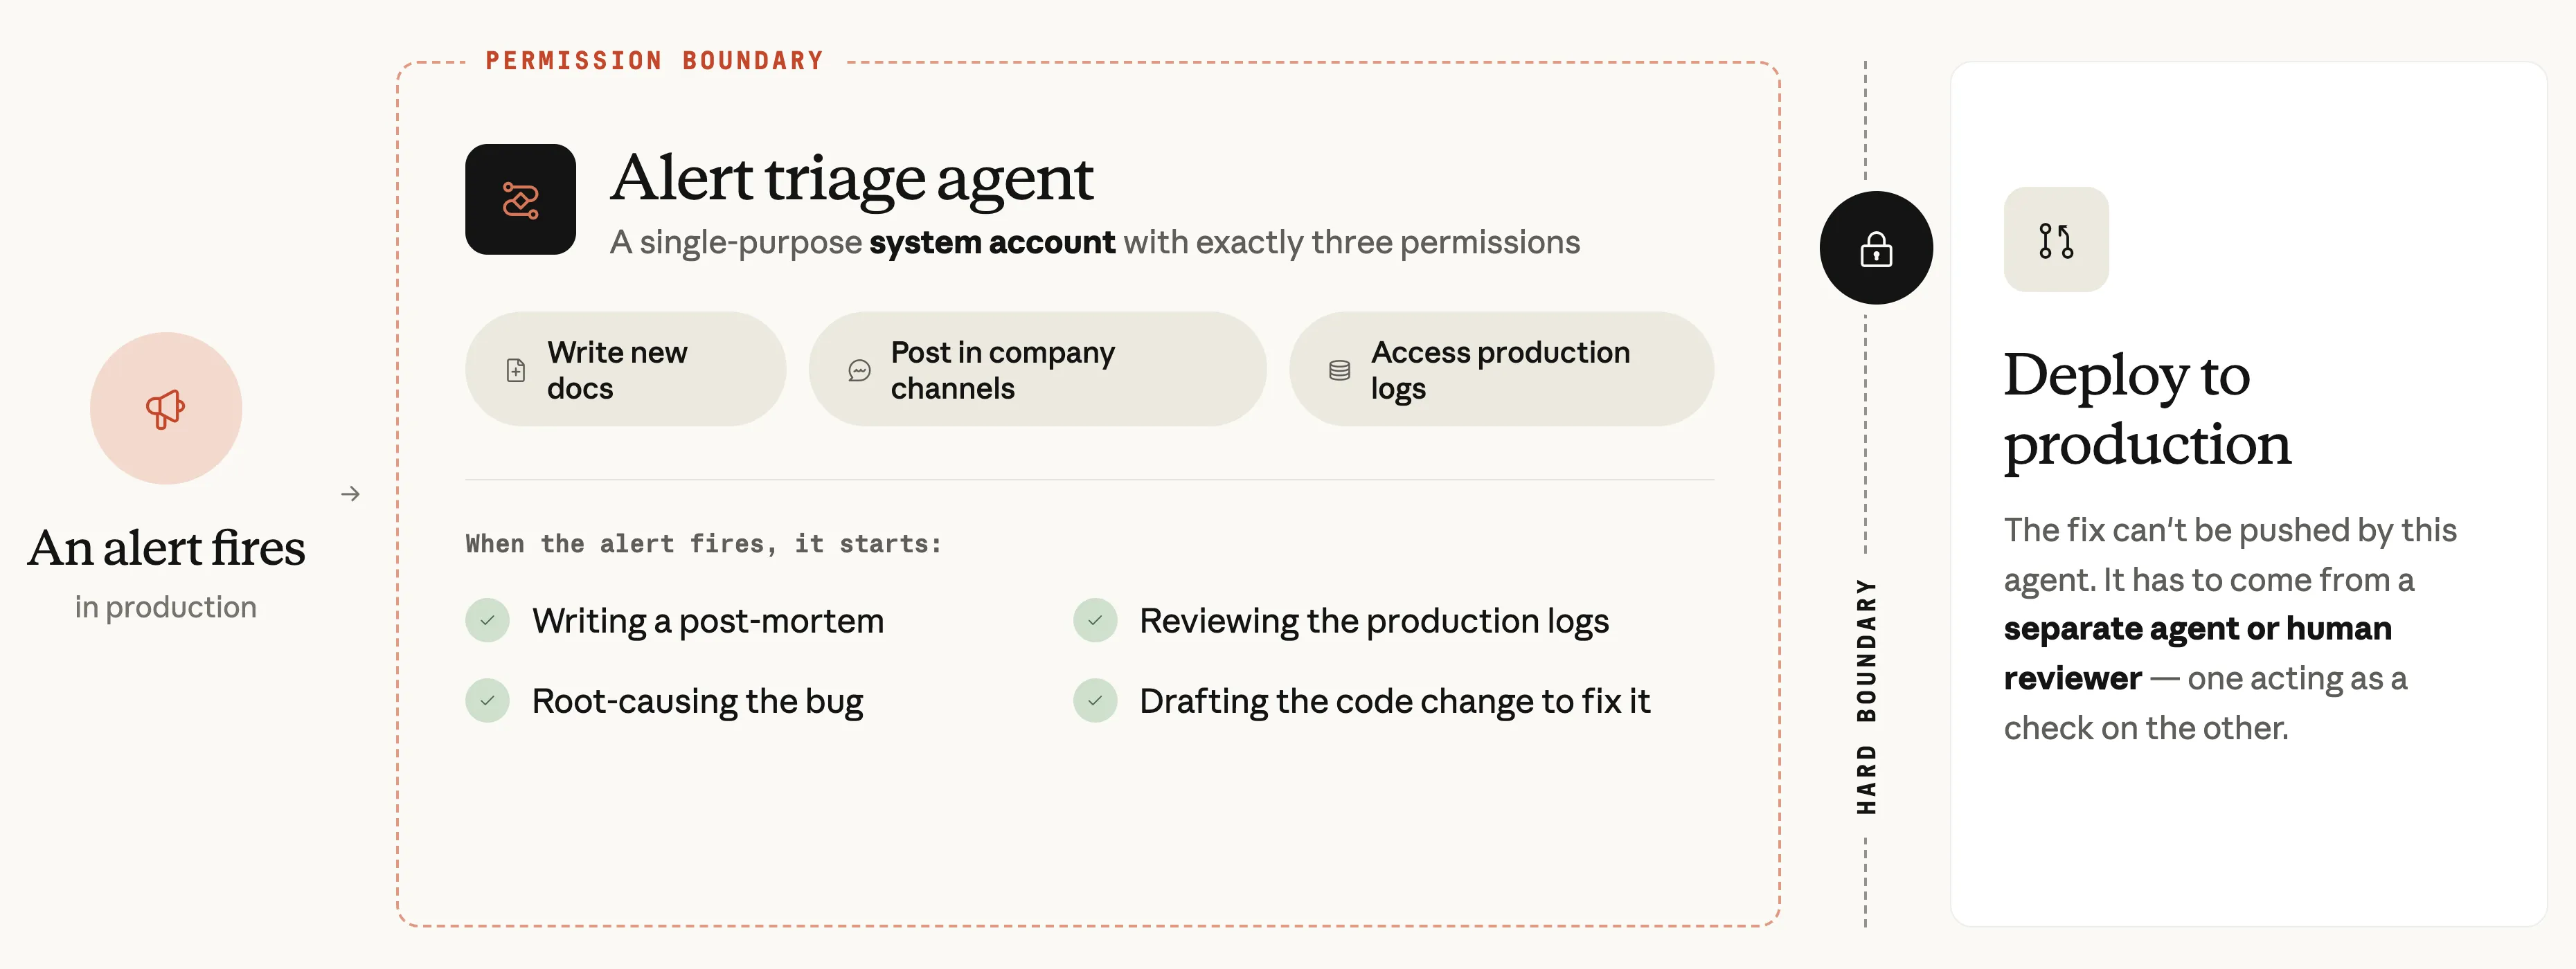
图:Agent 的有效权限不仅包括直接工具,也包括它能够请求和影响的其他 Agent。来源:Anthropic, How Anthropic secures its AI-native SDLC。
这个案例的教训不是“再写一句不许找别的 Agent”。而是计算 Agent 能力时,不能只看它自己的 tool list:
Effective capability
= direct permissions
+ reachable agents and services
+ delegated credentials
+ downstream automation
如果 Agent A 只能发消息,Agent B 能改仓库,流水线又会自动部署,那么 A 的有效能力边界已经跨过了三套系统。安全设计必须回答:B 如何验证请求来源?委派是否继承原任务风险等级?最终动作使用谁的身份?哪一道 Gate 不可绕过?
这也是 Zero Trust for AI agents 和 Agent identity access model 值得与 Playbook 一起读的原因。自主 Agent 需要独立、可撤销、可审计的 service identity;权限要按任务和环境收窄,网络出口与文件系统要隔离,审计要覆盖工具调用、Agent 间消息和自动批准,而不是把所有动作都挂在人类用户的长期凭证上。
第四层:Human-in-the-loop 还不够,必须说清人在哪一层负责
“保留人在回路中”听上去很安全,却经常只是把人放在最后点一下确认。
Anthropic 真正有价值的变化是:人的注意力不再平均摊在每一行代码上,而是按风险集中到少数高杠杆位置。
| 决策位置 | 人主要判断什么 |
|---|---|
| Intent Gate | 问题是否值得解决,目标、范围与责任人是否清楚 |
| Spec / Plan Gate | 业务语义、架构取舍、不可逆影响与验收标准 |
| Review Gate | 变更是否符合已批准意图,剩余风险是否可接受 |
| Production Gate | 凭什么现在可以上线,失败时谁能停止或回滚 |
| Exception Gate | Agent 的证据相互冲突、超出边界或触发异常时怎么办 |
低风险、易回滚、证据充分的常规改动,可以由 Agent 多做,人工抽样。涉及资金、身份、权限、合规、隐私和不可逆数据的改动,应保留领域 Owner 或安全人员深审。新 review agent 先进入 shadow mode,只发表评论不自动批准;经过红队测试和持续抽样,才逐步扩大权限。
这不是让人从流程中消失,而是让人退出机械劳动,回到判断与责任上。
Rami Pinku 把类似思路称为 Judgment-Driven Development:当执行变得便宜,工程系统要围绕“哪些地方真的需要人做决定”重新组织。我认为这个名字甚至比 AI-native 更准确。模型能力会变,工具品牌会变,但判断点、责任与风险不会自动消失。
第五层:真正的闭环发生在生产之后
很多团队说自己有 feedback loop,其实只是 Agent 在本地运行测试失败后继续修改。那是执行反馈,不是组织学习。
Anthropic 的 Maintain 阶段把生产信号重新送回 Plan。告警触发后,Agent 可以读日志、定位原因、写复盘,甚至准备修复;小而明确的问题走 PR,大问题变成新的 intent.md。安全扫描发现的新漏洞类型,则回写到 Skills、CLAUDE.md、review policy 和 eval,减少同类问题再次出现。
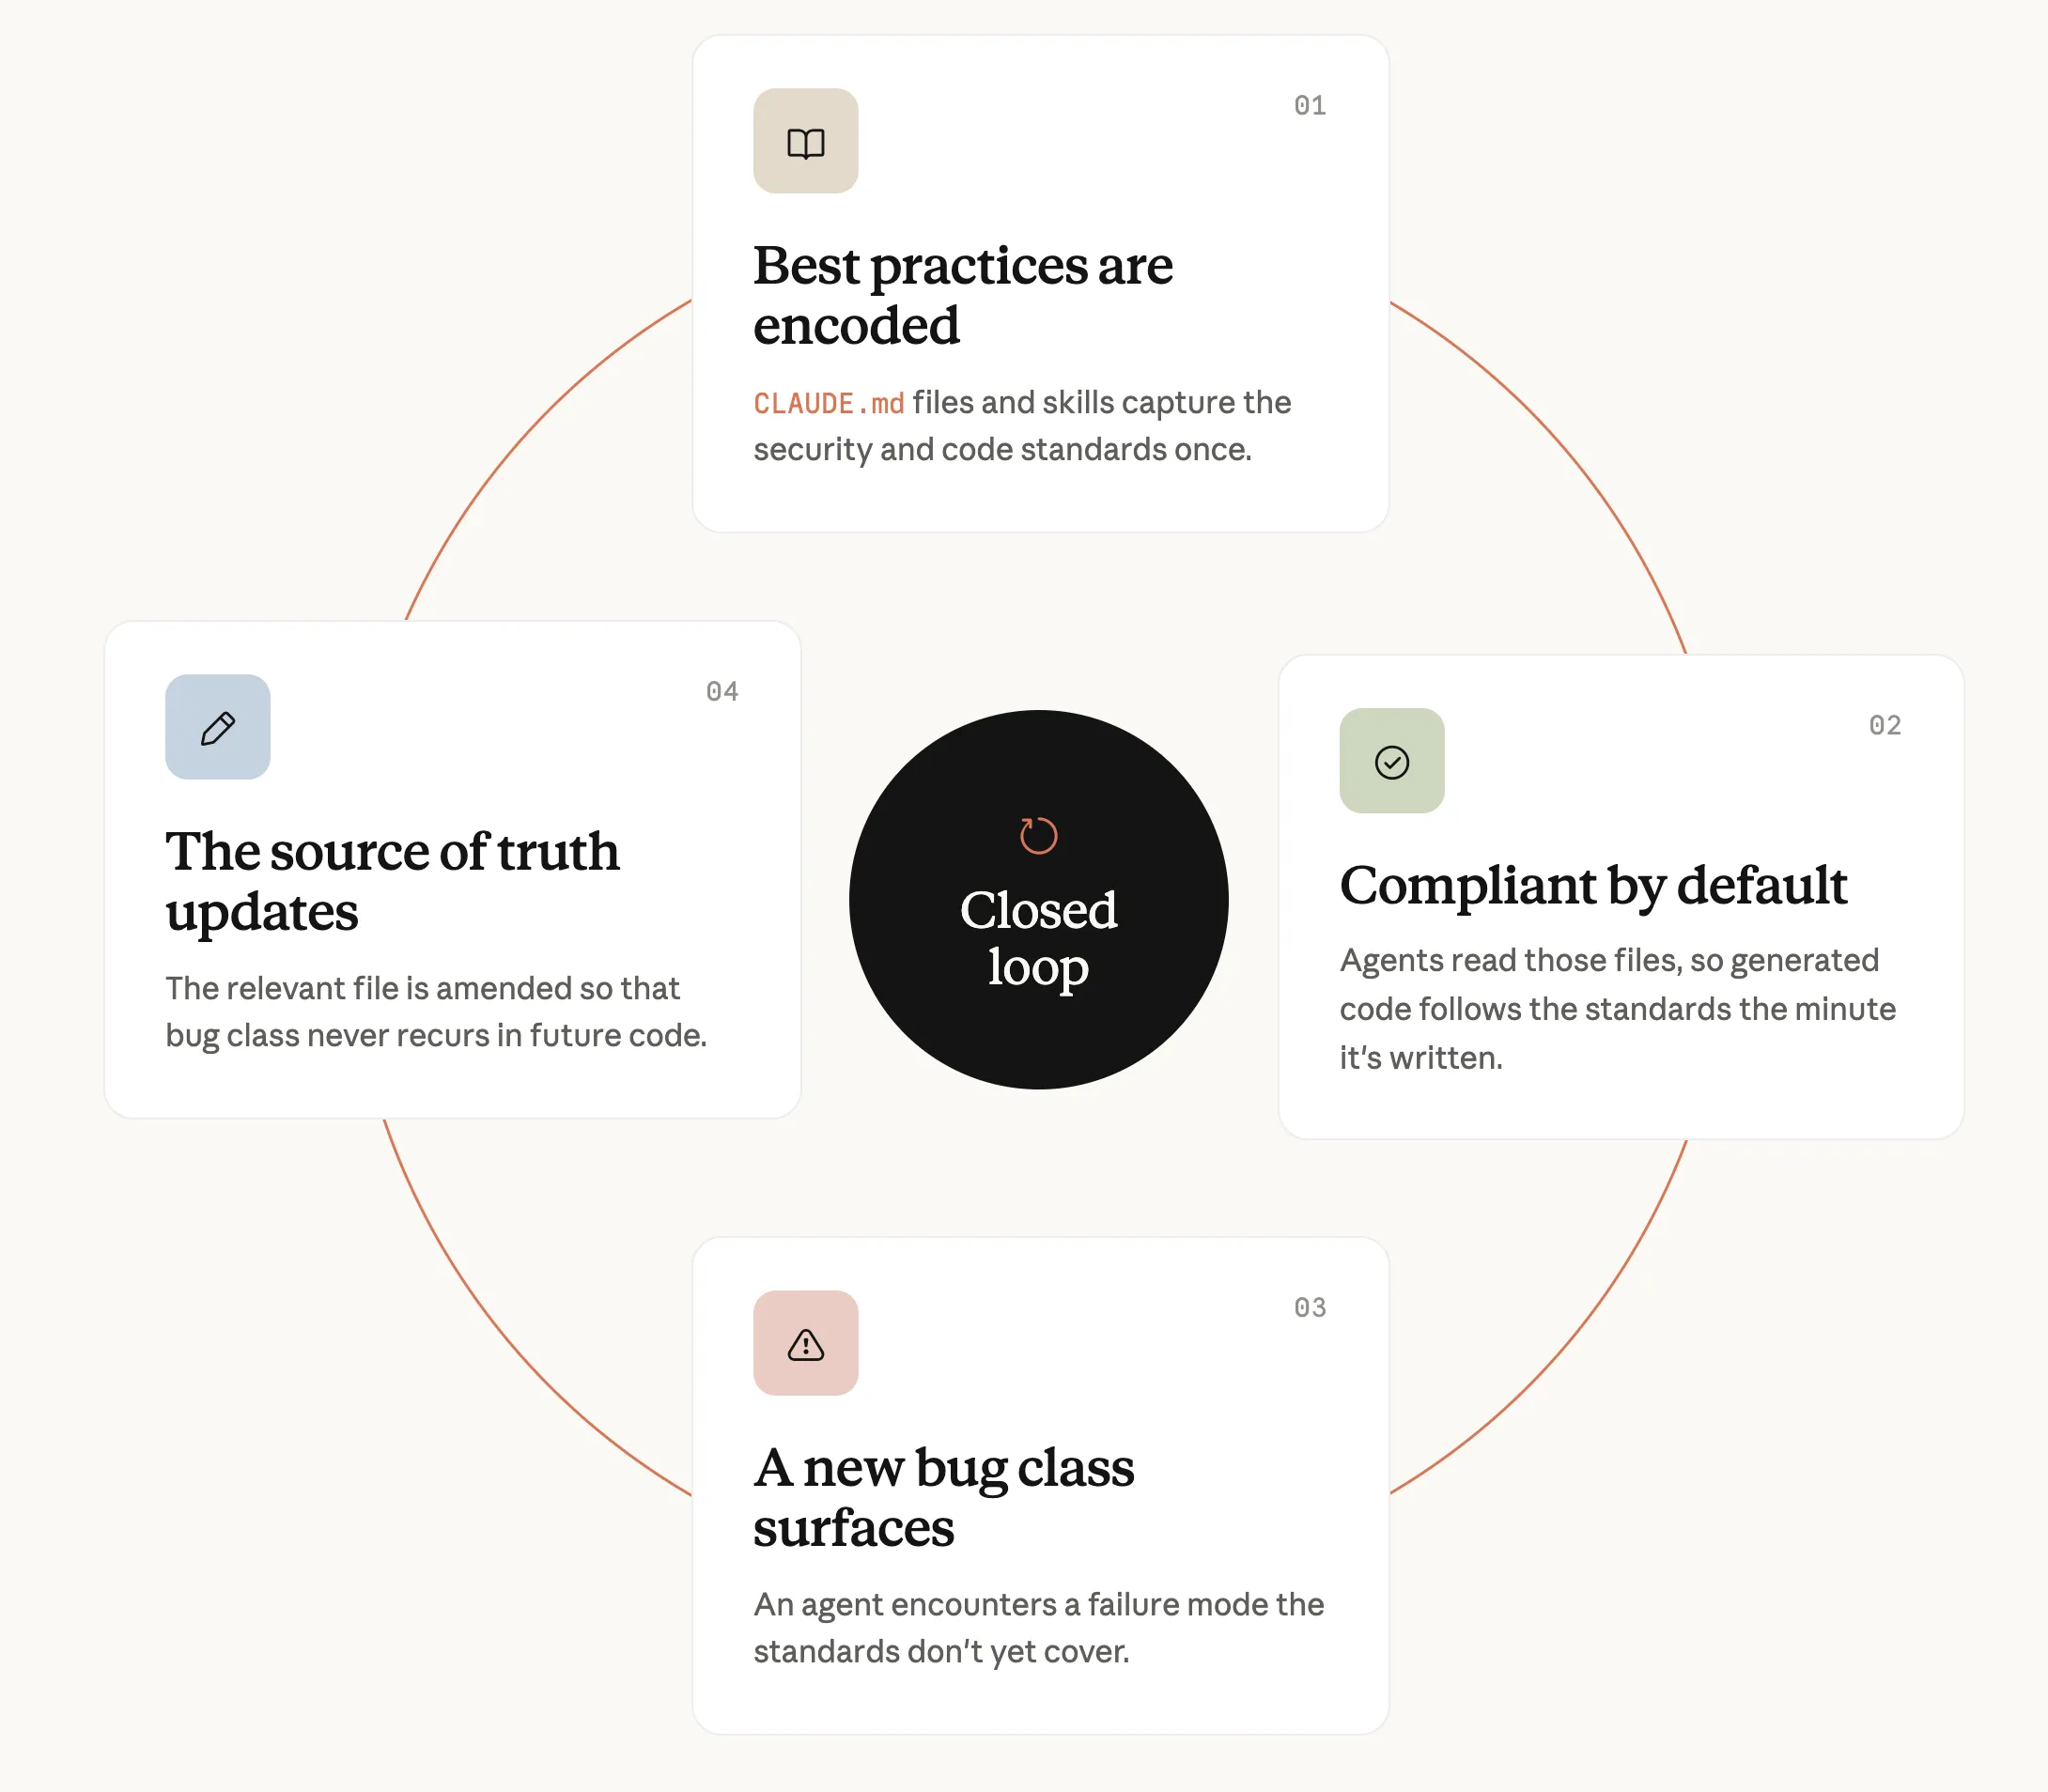
图:安全发现只有回写到指导、测试和评审规则,才会成为组织可以复用的改进。来源:Anthropic, How Anthropic secures its AI-native SDLC。
这里有一个容易被浪漫化的地方:自动回写规则并不天然等于“系统自我进化”。规则会过时,错误经验会固化,eval 会被优化到失去代表性,多个 Agent 也可能共享同一模型的相关性盲区。
因此,Anthropic 的治理重点不是看每一个 Bug,而是看循环本身:
- 新规则是否真的降低了同类问题复发率?
- 自动审批是否定期被风险加权抽样?
- 新 review agent 是否经过 shadow mode 和恶意变更测试?
- Agent 动作、工具调用和 Agent 间消息是否进入 SIEM?
- 模型、Prompt、Skill 或权限变化后,eval 是否仍能代表真实风险?
安全工程师的工作从“盯 Bug”变成“盯循环”,并不意味着工作更少;只是治理对象从单个输出升级成了一套会变化的控制系统。
社区最有价值的反驳:左侧需求工程被压得太薄
Anthropic Playbook 目前最锋利的批评,来自 Simon Martinelli 的 《Code Is No Longer the Bottleneck. Requirements Are.》。
他的核心质疑很具体:Playbook 从一位 originator 的想法出发,让 Claude 追问后生成 intent.md,再在一次会话里压缩需求和设计;但真实系统往往有多个利益冲突的部门,有领域模型、业务规则、非功能需求、例外流程和法规约束。这些工作不会因为 Agent 很会提问就自动完成。
更严格地说,Playbook 的左侧至少还缺几类一等公民:
- 多 Stakeholder 的冲突发现与决策记录;
- 可测量的性能、可用性、隐私和数据保留要求;
- 领域实体、状态机、业务不变量与异常流程;
- 从 Requirement 到 Test、Policy 和生产指标的 traceability;
- 需求质量指标,而不只是从 Intent 到 Spec 花了多久。
这个批评成立。Agent 从坏需求生成 5,000 行代码,只会更快地得到 5,000 行错误代码。对一个边界清楚的小功能,结构化 intent.md 和 spec.md 可能足够;对支付、订单、身份、医疗或跨部门系统,一轮对话不能替代需求工程。
Reddit 社区的另一个担心也值得保留:这套方法会不会把敏捷重新做成一套由 Agent 生成的瀑布文档?答案取决于 Artifact 是否真的是活状态。如果 Spec 变化能触发 Plan、Task、Test 和实现同步更新,它是可执行控制面;如果每个阶段只是生成一篇没人读的长文,它就是自动化官僚主义。
所以我会给 Anthropic 的方法加一条限制:
Artifact 的数量应由需要被稳定传递和验证的决策数量决定,而不是由 Playbook 的模板数量决定。
这套方法不该怎样复制
从社区讨论和外部研究看,至少有四种危险的误读。
误读一:AI 写得多,就是团队更有生产力
Anthropic 的 8 倍是内部代码交付量。Faros 看到更多 PR 和更长 review,DORA 看到 AI 放大组织能力。METR 2025 的随机对照实验 甚至发现,16 位熟悉大型开源仓库的资深开发者在 246 个任务上使用当时的 AI 工具,完成时间反而增加 19%。到 2026 年更新,METR 认为新工具可能已经带来加速,但选择偏差、多 Agent 并行与计时困难让结果无法可靠估计。
这些结果并不互相否定。它们说明生产力取决于任务、模型、仓库熟悉度、harness、验证成本和周围流程。不要用任何一个数字回答所有团队。
误读二:把所有旧流程删掉,就是 AI-native
旧流程背后通常有一个控制目标:责任、可追溯性、安全或合规。可以删掉过时的实现方式,但必须保留控制目标,并找到速度匹配的新 enforcement。把月度委员会改成 risk policy + automated evidence + named Gate 是重构;直接取消审批只是失去控制。
误读三:多 Agent Review 自然比人可靠
如果多个 reviewer 使用同一模型、同一上下文、同一 Prompt 模板,它们可能只是重复同一盲区。职责分离需要独立上下文、不同检查目标、确定性工具交叉验证、发现附带 proof,以及人类对高风险样本复核。
误读四:一开始就自动闭环
Anthropic 的很多做法建立在成熟基础设施上。普通团队更应该先手动跑通每一段,确认输入、输出、失败方式和 Owner,再把“上一个 Artifact 被接受”变成下一个动作的触发器。自动化一个还没理解的流程,只会让错误更快、更安静。
普通团队可以从一条小链开始
Playbook 本身给了一个很好的信号:这些 plays 是模块化的,而且有依赖关系,不需要一次完成六个阶段。
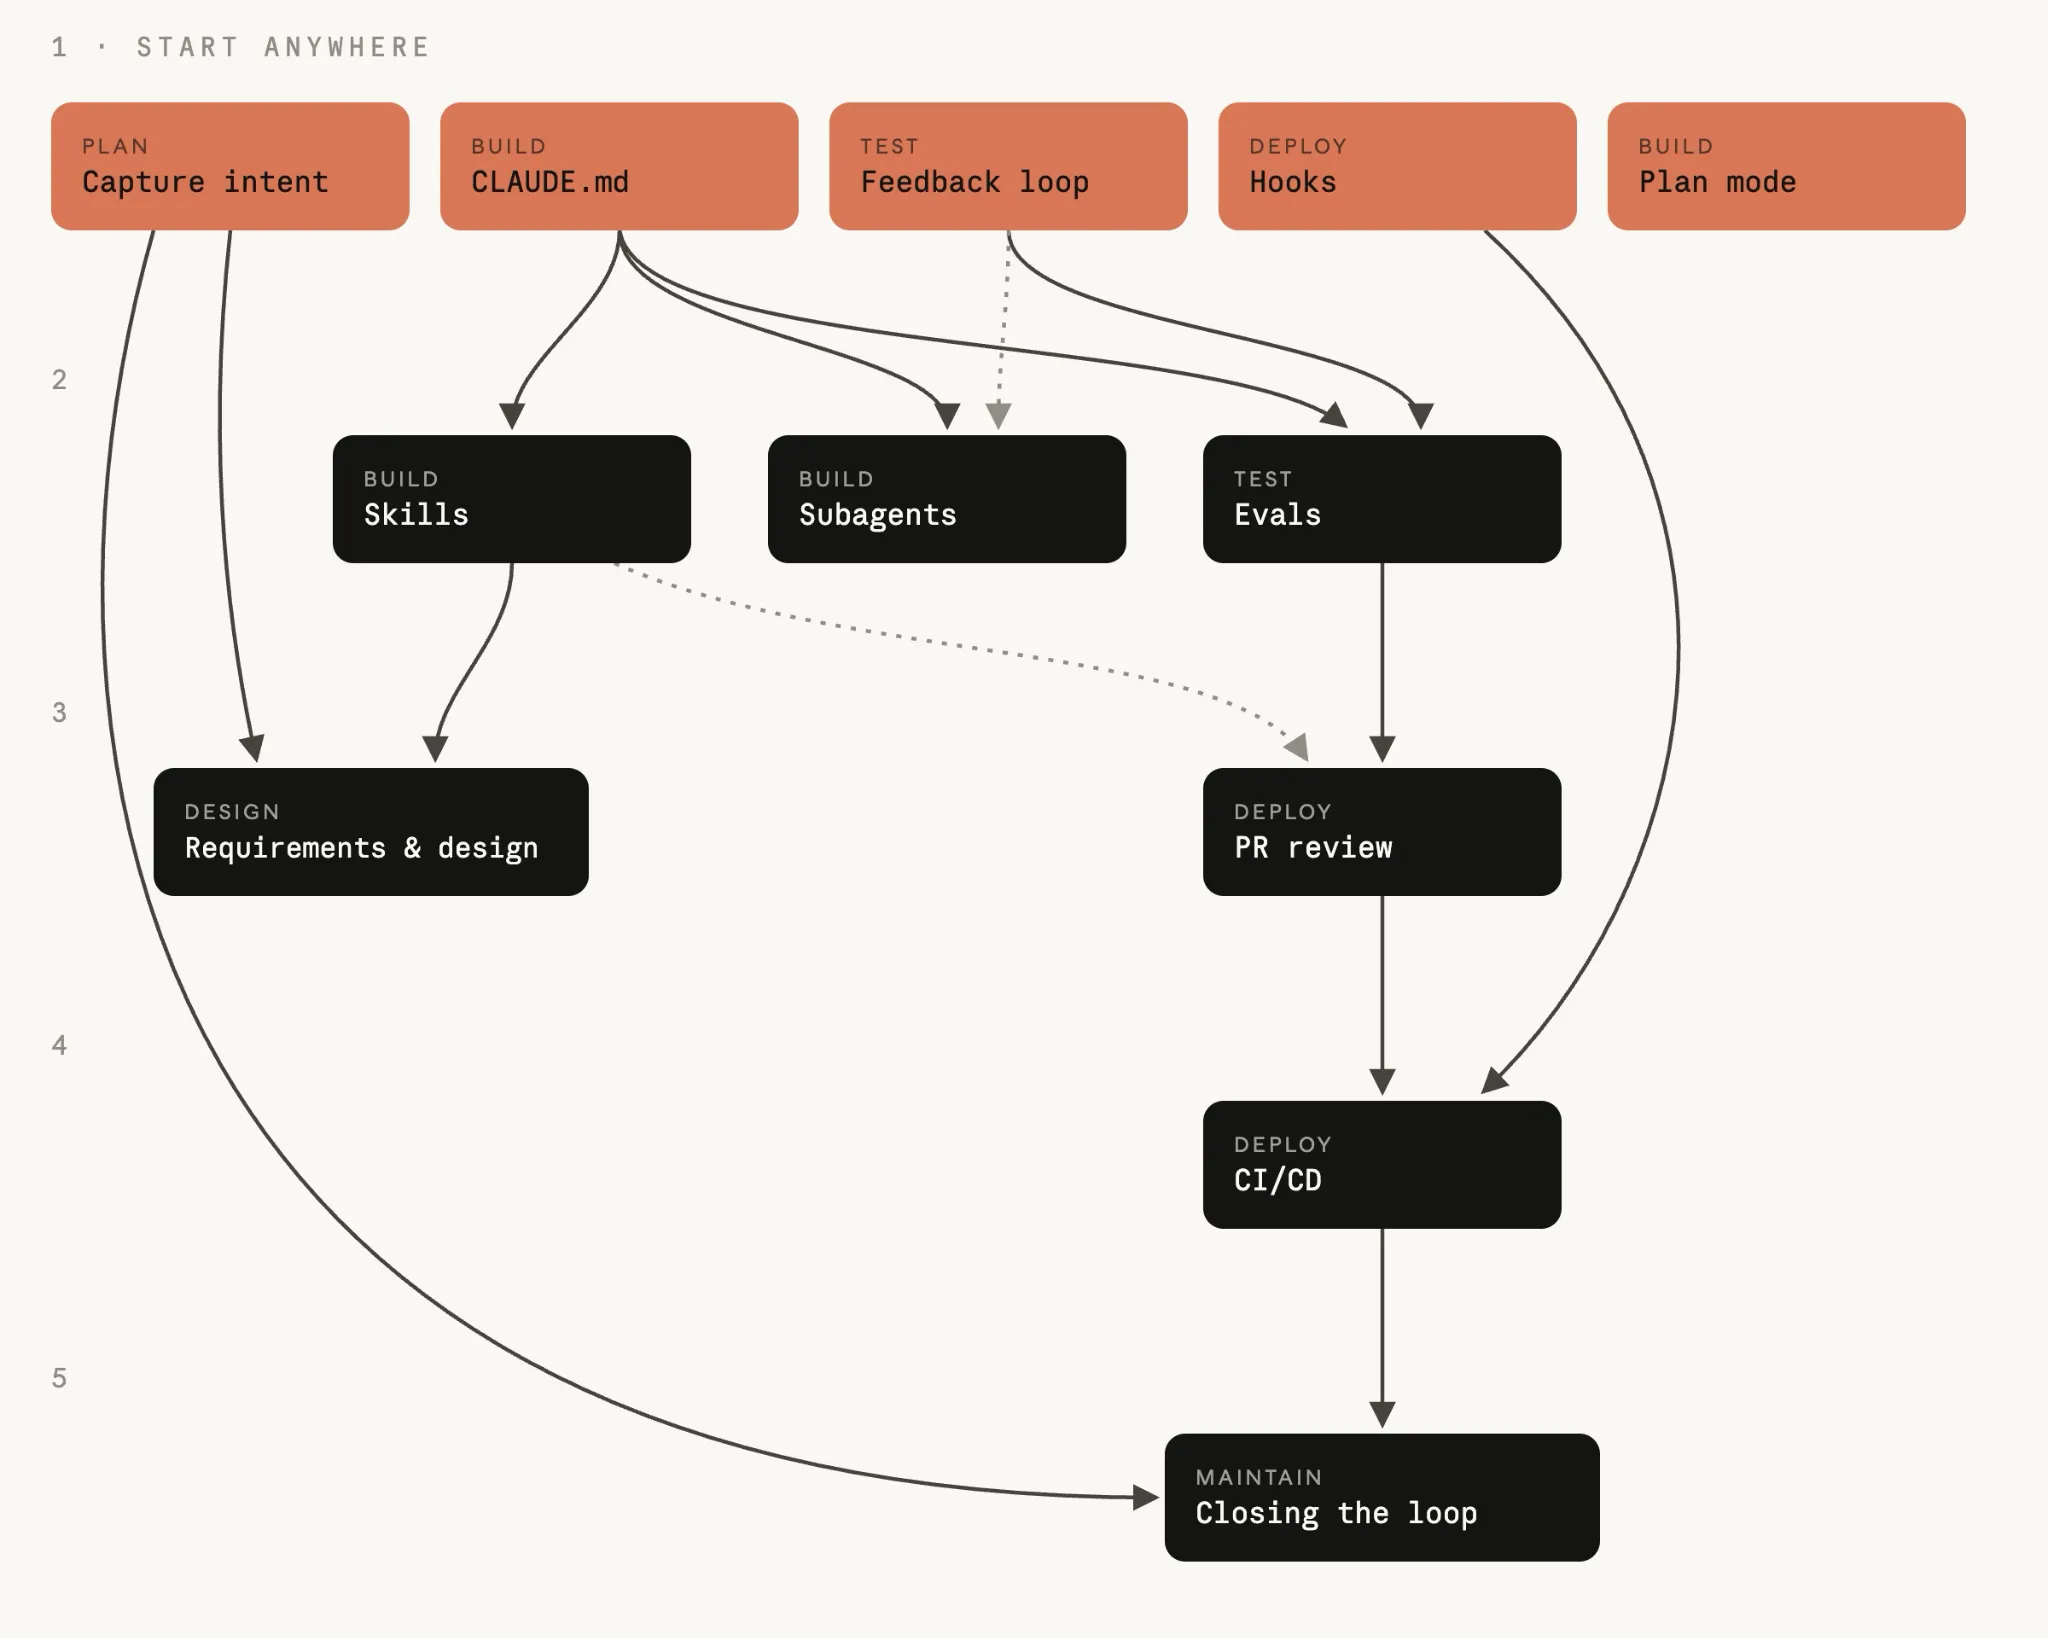
图:Anthropic 将 plays 设计为可按依赖逐步采用的模块,采用顺序并不等于六个 SDLC 阶段的排列顺序。来源:Anthropic, The AI-Native SDLC playbook。
如果让我给一个还没有 AI-native 平台的团队设计第一个月,我会选一类低风险、重复、结果容易验证、回滚便宜的任务,例如依赖升级、内部工具小改动、文档修复或只读事故初步诊断。
然后只做六件事:
- 建立一份权威 Intent:写清目标、范围、约束、Owner 和未知项。
- 要求先出 Plan:列出改动文件、顺序、风险、证据与回退,不允许直接改代码。
- 给 Agent 真实反馈:让它能运行测试、构建和必要的行为验证。
- 区分软规则与硬门禁:团队经验放进 instructions;权限、protected paths 和发布放行交给系统。
- 规定人工 Gate:谁审意图,谁审高风险改变,谁能批准上线。
- 让生产问题回写:每次失败至少更新一个 Test、Policy、Skill、Runbook 或 Intent。
第一轮仍然由人手动触发。等团队能回答“每一步读什么、产出什么、失败时停在哪、谁接管”,再把 Artifact 的接受事件接成自动触发。
度量也不要从 AI 写了多少代码开始。更有用的是:
| 维度 | 可以观察的指标 |
|---|---|
| 意图质量 | Build 开始后 Spec 返工率、开放问题关闭率、需求到测试覆盖 |
| 交付流速 | Intent 到首个可审版本时间、PR 等待时间、部署 Lead Time |
| 证据质量 | Agent 声称完成但验证失败的比例、无 proof 的发现比例、eval 漏检 |
| 风险控制 | 自动批准抽样错误率、越权尝试、Gate 绕过、回滚率 |
| 组织学习 | 同类问题复发率、事故到新 Test/Policy 的回写时间、规则过期率 |
| 业务结果 | 采用、留存、客户反馈和真正解决的问题,而不是 LOC 或 PR 数量 |
最后:AI-native 的对象不是代码,而是交付系统
Anthropic 这套方法最好的部分,不是 intent.md、Claude Code Plan mode、Skills、Hooks 或 Claude Tag 的功能清单。这些都可能随着产品和模型变化。
真正稳定的是它重新划分了五件事:
- 用什么承载已经批准的状态;
- 谁负责把状态推进;
- 什么证据证明推进正确;
- 哪些边界决定动作能否发生;
- 生产现实如何改变下一轮意图与规则。
传统 SDLC 主要管理人类协作。AI-native SDLC 还要管理一群高吞吐、非确定性、可调用工具、会读取不可信输入、甚至能彼此委派的执行者。它不能只靠更聪明的 Prompt,也不能只靠更多自动审查。
代码写快之后,软件工程没有变得不重要。恰恰相反,它从“如何正确实现”扩展成了“如何建立一套能持续产生正确实现、能证明、能约束、能纠错的系统”。
这才是我从 Anthropic 两篇文章里学到的核心。
参考资料
Anthropic 官方
- Louis Claxton, The AI-Native SDLC playbook, 2026-08-21.
- Jason Clinton, How Anthropic secures its AI-native software development lifecycle, 2026-07-21.
- Fiona Fung, Running an AI-native engineering org, 2026-06-03.
- Anthropic, Zero Trust for AI agents, 2026-05-27.
- Noah Zweben, Agent identity in Claude Tag: a new access model for autonomous, team-wide AI, 2026-06-24.
- Anthropic Institute, When AI builds itself.
研究与社区讨论
- DORA, State of AI-assisted Software Development 2025.
- DORA, Balancing AI tensions: Moving from AI adoption to effective SDLC use, 2026-03-10.
- Faros AI, The AI Productivity Paradox.
- GitHub, Spec-driven development with AI: Get started with a new open source toolkit, 2025-09-02.
- METR, Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity, 2025-07-10.
- METR, We are Changing our Developer Productivity Experiment Design, 2026-02-24.
- Simon Martinelli, Code Is No Longer the Bottleneck. Requirements Are., 2026-08-26.
- Rami Pinku, Anthropic Just Described the Operating Model I’ve Been Writing About for a Year, 2026-08-29.
- Reddit r/ClaudeAI discussion, 2026-08.
中文解读
- 阳哥书房 / Datawhale, 重磅!Anthropic内部AI Native经验公开了!, 2026-08-29.
- 架构师, Anthropic 公开了 AI 原生开发实践:规划、设计一直谈到部署和生产维护, 2026-08-27.
文中 Anthropic 官方图片均来自对应官方 Blog,版权归 Anthropic 所有,此处用于评论与学习笔记,并保留来源链接。两张自制流程图由 OpenAI 内置 ImageGen 生成,提示词与生成记录保存在本文 assets 中。