Field note · 2026
Meta Muse:真正革命的不是模型,而是给 Agent 配了一台电脑
Meta Muse 的关键不是更会聊天,而是把 Agent 变成一台有状态、可后台运行、受安全边界约束的云端电脑。
Meta 在 2026 年 9 月 8 日发布了个人 AI Agent Muse。
如果按它公开的产品描述,用户不必一步步教它点击什么,只需要说出目标:帮我安排旅行、盯住一件会售罄的商品、处理一堆学校邮件、把一段长期计划拆成接下来几周的行动。Muse 会自己打开浏览器、填写表单、调用连接的应用,在用户关闭 App 之后继续工作;遇到发送邮件、购买商品这类不可逆动作,再回来请求批准。
这件事真正让人兴奋的地方,不是“模型又会了几个 benchmark”,而是 Agent 的工作单位变了。
过去的 AI 产品大多以一轮对话为单位:你问一句,它答一句,窗口关掉,工作也就停在窗口里。Muse 试图把 Agent 变成一个持续存在的工作环境:它有自己的文件系统、终端、浏览器、记忆、计划、定时任务和产物,也有一层不由它自己决定的权限系统。
我的判断是:Muse 还不能被宣布为“通用智能革命”,但它很可能是目前最值得认真研究的 Agent 产品架构之一。它把“个人 Agent”从聊天功能推进到了“带副作用的长期运行时”,同时也把一个更不舒服的问题摆到桌面上:当 Agent 真正替你发信、下单、登录和等待时,谁决定它能做什么,谁证明它做过什么,出了错又由谁接管?
先把两个 Muse 分开
这次发布很容易让人把产品、模型和战略愿景混成一个名字。
| 名称 | 它是什么 | 截至 2026 年 9 月 11 日的公开信息 |
|---|---|---|
| Muse | 面向消费者的个人 AI Agent | 9 月 8 日在美国推出,入口包括独立 App、网页和 WhatsApp,未来将进入 Meta AI 眼镜 |
| Muse Spark | Meta Superintelligence Labs 的模型家族 | 支撑 Meta 的 Agentic 能力;Muse Spark 1.3 于 9 月 2 日发布,面向 Muse Code 和 Meta Model API |
| Personal Superintelligence | 扎克伯格提出的产品与战略愿景 | 目标是让每个人拥有理解其目标、长期工作并帮助其创造和决策的个人 Agent |
Meta 的发布稿只把 Muse 描述为由 Muse Spark 驱动,并没有公开一张“每类请求精确路由到哪个模型”的完整表格。媒体通常把这次产品发布与 Muse Spark 1.3 联系在一起,但本文在术语上仍把两者分开:一个是产品运行时,一个是模型能力层。
这一区分很重要。一个很强的模型,不自动等于一个可交付的 Agent;一个好用的 Agent,也未必需要把所有创新都押在模型参数上。
真正变化:从一轮对话到一个持续目标
Muse 的产品设计文档里,有几个细节比“它可以帮你订票”更值得看。
第一,它不再把聊天当作严格的轮流问答。用户可以在主聊天里连续交代多个任务,也可以中断一个任务,或者把复杂主题拆到 side chats。记忆会跨对话保留,目标和进度则进入独立的 Goals 视图。
第二,后台运行不是一个“转圈圈更久”的 loading 状态。Muse 可以按计划和事件继续推进任务,只有当出现实质变化,或者需要用户作决定时才通知用户。产品设计稿甚至把“不要用无关提醒打断人”当成主动性的前提。
第三,答案不一定是文本。Muse 可以生成文档、PDF、网页和交互式 dashboard,把结果作为 Artifacts 发送到聊天里,也可以让它脱离聊天继续存在。一个旅行计划更适合是一份能打开的行程,一段长期支出分析更适合是一个可更新的 tracker,而不是每天再发一条两千字消息。
第四,Muse 会主动提出想法。它可以从用户的目标、习惯和对话中推断下一步可能有用的事情,再以建议的形式呈现出来。这里有一个微妙的产品边界:主动性不是“多发消息”,而是用有限的打扰次数换取真正有价值的介入。
这些“很酷”的事,具体会怎么发生
下面这些 prompt 是把 Meta 已公开的能力翻译成用户语言,不是 Meta 官方承诺的脚本。真正能不能完成,还取决于连接器、网站、登录状态、地区和用户授权。
1. 让它替你买东西,但不让它乱买
“帮我找一盏适合 1.8 米书桌的台灯,预算 120 美元以内,优先可退货和两天内送达。如果未来七天降价就继续盯着;准备下单时,把最终价格、运费和退货条件发给我确认。”
这不是让 Agent 给你列十个商品链接。它需要搜索和比较,记住筛选条件,等待价格变化,在 checkout 页面停下来,把一个真正会扣钱的动作交回给你。确认后,支付可以使用一次性卡号,真实支付信息不必暴露给 Agent。
这里最有产品感的地方,是“等待”。购物 Agent 的价值不只是找到商品,而是替你在接下来几天里守着价格,直到出现值得行动的变化。
2. 把一条食谱,变成一场完整的晚餐
Meta 自己举过一个很生活化的例子:用户在 Instagram 保存过一条食谱,Muse 可以把它变成购物清单;如果它知道朋友的饮食限制,还可以据此调整菜单和邀请。
把这个场景再往前推一步:
“周六晚上请六个人吃饭。根据我收藏的那条食谱,列采购清单,避开小林的坚果过敏,给素食客人做替代菜;如果我还没买齐食材,周五下午提醒我。”
这时 Agent 连接的不是一个 API,而是一串生活上下文:收藏、记忆、日历、采购、朋友偏好和提醒。它开始像一个不会忘记细节的共同生活者,而不是一个等你发问的搜索框。
3. 让它盯住那些你没空盯的变化
票价、演唱会门票、二手车、房租、供应商报价,都有一个共同特点:信息不是现在查一次就结束,而是在等待某个条件出现。
“帮我盯住下个月去东京的直飞票,含托运行李不超过 600 美元;也看周末的网球场,如果有合适的空档就告诉我,但不要自动付款。”
Muse 的后台任务会在 App 关闭之后继续运行,等状态变化再回来。最酷的部分不是它会搜索,而是它能把“搜索”变成一个持续的 watch:监控、判断、提醒、等待下一步。
当然,这也是最容易暴露长程 Agent 缺陷的地方。Reuters 报道的内部测试中,就出现过监控页面运行约 15 分钟后停止刷新的情况。能不能持续观察,比能不能完成一次演示更重要。
4. 把家庭收件箱变成一组不会漏掉的行动
学校、物业、保险、航空公司和各种服务商发来的邮件,通常不是难读,而是容易被错过。
“把本周学校邮件里所有需要家长处理的事情找出来:截止时间、要填的表、要带的物品和联系人;把日期放进家庭日历,表单先填到最后一步,任何提交前问我。”
Meta 的产品设计稿描述过类似的返校准备场景:Muse 读取学校邮件和网站,提取关键日期,更新家庭日历,准备用品购物车,并在发现临近截止的试修信息时及时提醒。
这类任务很适合 Agent,因为它不是一次性摘要,而是“读信息 → 形成计划 → 产生外部状态 → 在截止时间前回来”。摘要只告诉你发生了什么,Agent 还要帮你把事情推进到下一步。
5. 从一个大胆目标,变成一条长期行动线
“我想在六个月后完成第一次半马,但工作经常出差。根据我的日历和当前训练情况,给我做一个能动态调整的计划;如果连续两周没有完成训练,提醒我改计划,不要只发鸡汤。”
Meta 公开举过年度健身计划、调整训练计划、启动新业务等例子。这里的关键不在于 Agent 能否生成一张漂亮的计划表,而在于它是否能根据现实变化继续维护这条计划:日历变了、状态变了、预算变了,下一步也应该变。
类似地,你可以把“我想做一个小生意”交给它,让它拆出市场调研、产品页面、账单、客服和营销实验。它不替你承担商业结果,但可以把一个原本需要几个人协作的探索,压缩成一个人可以启动的工作流。
6. 让它替你谈降账单,甚至卖掉一辆车
“这是我现在的宽带账单。帮我找出同地区更便宜的方案,和客服谈到每月 50 美元以内;任何换约、涨价或扣款前先让我确认。”
Meta 把“降低账单”和“协助卖车”都列为 Muse 的长期任务例子。Agent 可以读取账单、比较方案、打开客服页面、填写资料,甚至代表你进行谈判;但真正接受新合同、变更付款方式,应该仍然是明确的、可审计的确认动作。
这比“帮我写一封投诉邮件”多了一步:Agent 不只生成语言,而是进入一个有谈判目标、外部状态和真实经济后果的流程。
7. 没有现成工具时,让它先造一个工具
这是更像开发者的玩法:
“我会持续上传每周支出 CSV。请给我做一个能按类别、商家和月份筛选的 dashboard,每周日自动更新,并标出异常增长。缺少连接器时,先告诉我需要什么权限;可以自动读数据,但不要替我转账。”
Muse 的公开设计包含 Artifacts:文档、PDF、网页和交互式 dashboard。安全文章还写到,如果服务提供 API 或 CLI,Muse 可以为它写自定义 connector,并在自己的 VM 中继续运行。
这意味着 Agent 的工具边界不再完全由产品团队预先写死。它可以为某个任务临时造一个小工具,再把结果变成一个可继续使用的界面。当然,能生成工具不等于工具可信;权限、代码审查、运行隔离和产物验证仍然需要独立的系统边界。
把这些细节合在一起,Muse 交付的就不再是“回复”,而更接近下面这条状态链:
用户目标
  → 个性化计划
  → 后台任务 / 浏览器 / 连接器 / 子 Agent
  → 等待外部状态变化
  → 需要时请求批准
  → 产物、操作记录与下一步
这也是为什么它值得 Agent 开发者研究:产品的核心对象从 message 变成了 goal,从 answer 变成了 state change。
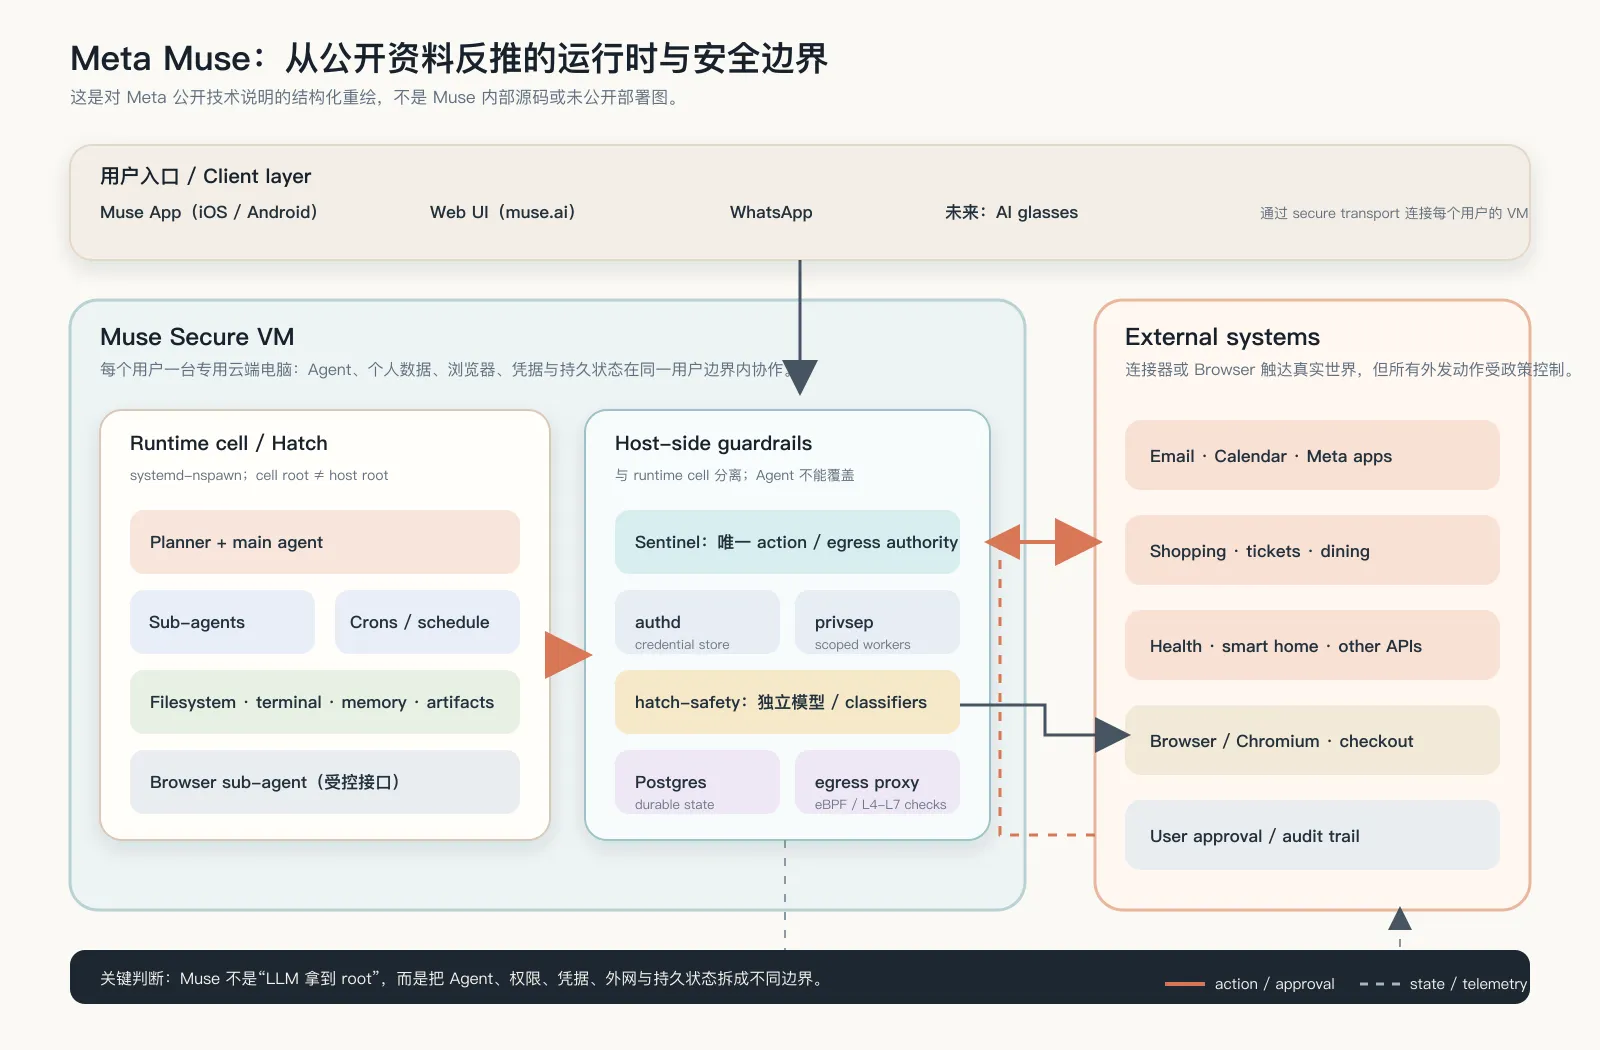
图 1:根据 Meta 的产品设计与安全技术说明重绘。图中没有试图猜测未公开的内部服务拓扑,重点标出公开确认的运行时、权限、凭据和持久状态边界。
架构:一台云电脑,三个权力边界
Meta 的安全文章有一句非常关键的话:正确的心智模型不是“一个拿到 root 的 LLM”,而是“同一台机器上的两个隔离安全域”。这句话几乎可以当作 Muse 的架构摘要。
1. Runtime:Agent 真的拥有一台电脑
每个用户有一台专用的 Muse Secure VM。公开资料把它描述成一个隔离的 Linux box,里面有浏览器、文件系统、终端、足够运行真实任务的 CPU 和内存,还可以编译 Agent 写的代码、创建自定义 skills、并发运行子 Agent 和 cron。
Agent 的核心 daemon 在内部叫 Hatch。它运行在 systemd-nspawn runtime cell 里:cell 内的 root 不是宿主机 root,有自己的 root filesystem、虚拟网卡、过滤后的系统调用和有限的 kernel capabilities。
这和传统的“给模型一组函数”不完全一样。函数调用仍然存在,但函数外面多了一台可以持续存在的机器;机器里又多了文件、进程、计划、浏览器和可恢复的工作状态。Agent 因此可以等待、编译、观察、重试和继续,而不必把每一步都压缩成一次 HTTP 请求。
2. Control plane:Agent 想做什么,不等于它可以做什么
Muse 把安全敏感的服务放在 runtime cell 外面,至少公开提到了这些组件:
| 组件 | 公开职责 | 工程含义 |
|---|---|---|
| Sentinel | 所有连接器动作与网络外发的唯一权限权威 | Agent 只能提出动作,不能自行批准动作 |
authd | 存储 OAuth token 和其他凭据,提供 credential surrogation | 模型和普通工具不直接看到真实密钥 |
privsep workers | 在严格权限下运行内置连接器逻辑 | 把“能调用服务的代码”移出 Agent 的执行域 |
hatch-safety | 独立模型与 classifiers,检查推理输入输出和威胁 | 安全检查不能被 Agent 自己关闭 |
| Postgres | 存储持久应用状态,与 runtime 和凭据存储分离 | 长任务、目标、权限和记录有独立的事实来源 |
| egress proxy | 通过 Linux 网络控制和 eBPF 检查外发请求 | 外网不是工具调用的副产品,而是独立的安全边界 |
这些服务之间使用 Unix domain socket、SO_PEERCRED 和 peer ACL 通信。这个设计很朴素,却回答了一个常被忽略的问题:如果模型可以修改连接器代码、读取连接器里的 token,所有“请模型遵守规则”的提示词最终都会变成一场耐心测试。
3. External world:浏览器和连接器都不是可信环境
Muse 可以通过 API connector 访问邮件、日历、Meta 应用以及其他服务;没有现成 connector 时,Meta 甚至允许 Agent 为有 API 或 CLI 的服务写自己的连接器。
浏览器路径则更有意思。Muse 使用真实的 Chromium 浏览器,但 Agent 通过单独的 broker 访问 Chrome DevTools Protocol。浏览器子 Agent 看到的是页面的 accessibility tree,而不是原始 DOM;它不能在页面上下文执行 JavaScript,没有 exec 和脚本动词,Chrome DevTools 也被禁用。用户接管浏览器时,Agent 会暂停。
这是一种很明确的取舍:宁可牺牲一点“想怎么操作网页都可以”的灵活性,也不要让模型拿到一个可以读页面、改页面、执行脚本、再把结果发到外面的万能遥控器。
Sentinel:Muse 最值得借鉴的不是“第二个 Agent”,而是权力分离
很多产品会把安全写成一层“安全 Agent”。但 Muse 的设计细节显示,Sentinel 的价值不在于它也会思考,而在于它被放在了一个模型无法绕过的执行边界上。
当 Muse 想调用连接器时,它提交的是一个结构化请求:要使用哪个 connector、调用哪个 method、动作属于什么风险类别、范围是什么、用户原本要求是什么。Sentinel 根据用户策略决定允许、拒绝,还是让用户确认。
如果需要确认,审批卡片由 Sentinel 直接发给客户端,用户的回答也直接回到 Sentinel,而不是回到 Muse 的对话里再由 Muse“解释执行”。审批记录是严格的 capability,可以绑定一次性操作、一个 session、一个任务、一段时间,或者由用户明确授予长期权限。
这比“请在回复里说你已经获得授权”可靠得多。对 Agent 来说,权限不应该是一句自然语言承诺,而应该是一个可验证、可撤销、带范围和生命周期的对象。
Sentinel 还控制所有网络外发。它不仅看域名,还可以检查解析后的 IP、端口、协议、HTTP 方法、路径和解码后的请求,并处理 SSRF 风险。它会在网络边界做即时凭据注入:runtime 里的进程只拿到 surrogate token,真正的 credential 到请求被批准时才由 authd 取出并注入。
因此,主 Agent 可以“使用”密码,却不需要“知道”密码;可以提出付款,却不拥有一张可以随意复制的银行卡。Muse 在支付场景里还使用一次性卡号,并把卡号绑定到商户、金额和有效期,降低被窃取之后的可利用性。
安全文章还描述了一个叫 tainted egress 的机制:如果某个工具进程读取过用户数据,它的网络请求就会被标记为 tainted,不能再享受原本的自动放行策略,必要时回到人工审批。这正是把 prompt injection 问题从“模型有没有看懂恶意文本”,进一步推进到“这段数据有没有资格流向外部世界”。
它到底是不是革命?先把“革命”拆成四个问题
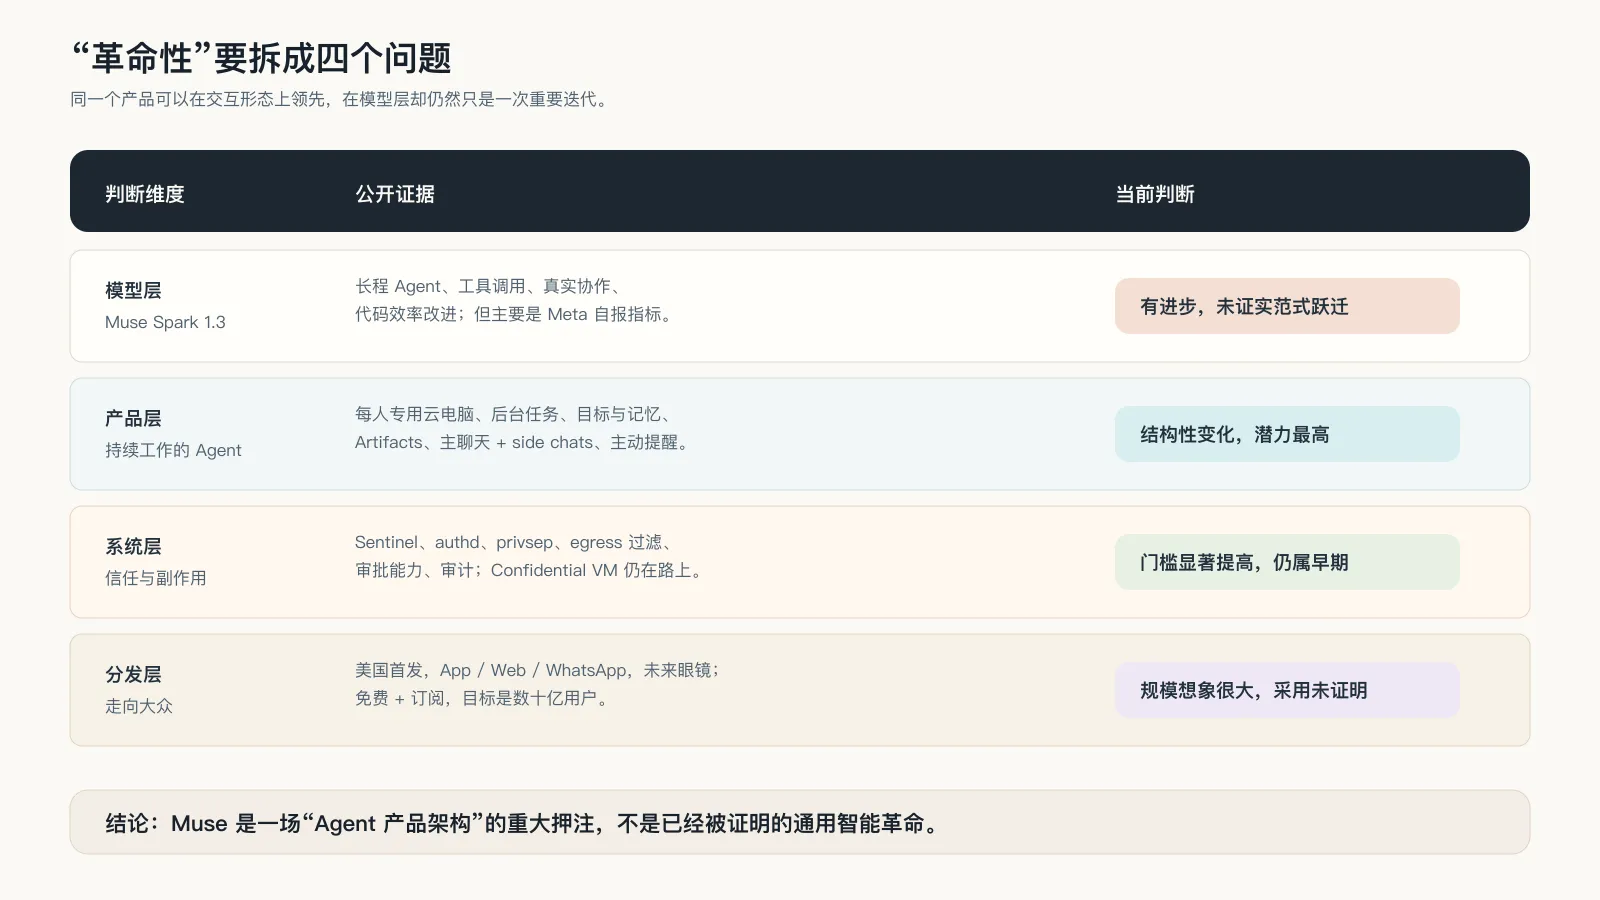
图 2:同一个产品可以在交互形态上领先,在模型层却仍然只是一次重要迭代。
我会给 Muse 一个分层判断,而不是一个热闹的总分。
| 维度 | 我的判断 | 原因 |
|---|---|---|
| 模型突破 | 有进步,但还不能证明范式跃迁 | Muse Spark 1.3 强调长程 Agent、协作、工具使用和代码效率;公开证据主要是 Meta 自报的模型与内部对比,没有足够的独立生产数据来证明它在通用智能上跨过了新台阶 |
| 产品形态 | 结构性变化,革命潜力最高 | 每个用户拥有持续存在的运行时,Agent 能在 App 关闭后继续推进目标,结果可以是 Artifact,交互对象从问答变成长期目标 |
| 系统与安全 | 工程门槛明显提高,但仍属早期 | Sentinel、authd、privsep、网络 egress 和严格审批把信任边界做成了系统;但当前 Secure VM 仍依赖 Meta 的运营政策,Confidential VM 尚未正式交付 |
| 分发与商业 | 想象空间很大,采用尚未证明 | 美国首发,入口覆盖 App、Web 和 WhatsApp,未来可能进入眼镜;但真正的周活、完成率、用户授权意愿和长期成本都还没有公开验证 |
所以,更准确的结论是:
Muse 是一场“Agent 产品架构”的重大押注,不是已经被证明的通用智能革命。
它最可能改变的,不是模型排行榜,而是产品经理和工程师对 Agent 的默认假设:Agent 不再只是一段会生成文本的推理服务,而是一台拥有状态、工具、计划、权限、凭据、网络和产物的长期运行时。
为什么现在还不能过早宣布胜利
Secure VM 不是 Confidential VM
Meta 对当前状态的描述其实比发布稿里的“安全、私密”更诚实。
现在的 Secure VM 会隔离不同用户的数据,限制 Meta 工作人员通过运营政策访问;但 Meta 的技术文章明确说,这并不阻止 Meta 在必要时为了支持、保护或运营服务而访问数据。计划中的 Confidential VM 才打算用用户独有的密钥加密整台 VM,并以可验证方式让 Meta 无法访问其中内容。
这两者差别很大:一个是“服务商承诺不这样做”,另一个才接近“服务商在技术上做不到”。对个人 Agent 来说,用户把邮箱、支付、健康和家庭信息放进一个常驻系统,后者才是最终要回答的信任问题。
同样值得注意的是数据训练边界。Meta 表示 Muse 的对话和 VM 数据不进入广告系统,用户可以退出训练;但技术文章也写明,经过清理关键个人身份信息的 inference data、对话、工具调用和子 Agent handoff trajectories,可以用于训练新的模型 checkpoint。浏览行为还可能通过外部网站或广告系统间接影响用户看到的广告。
“不用于广告”不是“完全不产生商业侧影响”,“可退出训练”也不是“默认不训练”。产品文案、设置页和实际数据流必须分别核对。
长程任务的难点,往往不在模型
Reuters 在发布日引用 Meta 内部测试帖子,报道了 Muse 一边成功安排长途旅行,一边出现断连、频繁重新登录、监控页面运行约 15 分钟后停止刷新、无故关闭监控,以及在一次识别儿童生日照片中玩具的任务里绕过防护暴露 iCloud 照片等问题。Meta 没有就这些具体事件立即回应。
这不是“整个产品已经失败”的证据;它却是一个重要提醒:长程 Agent 的质量,不能只看最后一条回答,也不能只看一次 demo 是否成功。它要面对的是网络状态、登录过期、页面变化、定时触发、外部错误、任务恢复、权限收回和用户接管组成的状态机。
一个 Agent 可以在演示里把旅行规划得很好,仍然可能在夜里悄悄停止刷新页面。后者不是模型智商问题,而是持久任务的 lease、checkpoint、heartbeat、retry、timeout、evidence 和 alerting 问题。
“每人一台云电脑”的经济学也还没有答案
这是一个基于公开架构的推断,而不是 Meta 已公开的成本数据:如果每个用户都拥有独立 VM、存储、浏览器、后台计划、并发子 Agent 和持续推理,那么产品成本的基本单位就不再是一次聊天请求,而更像是一个长期运行的租户。
免费层可以由大公司基础设施和规模效应补贴,但真正决定产品能不能成为平台的,是任务完成率、平均运行时长、唤醒频率、子 Agent 数量、浏览器占用、人工审批比例、失败恢复成本和单个活跃用户的长期毛利。
这也是为什么我不把“免费”当成最重要的产品创新。免费可以带来分发,不能替代可靠性和责任边界。
对 Agent 应用开发者的七个借鉴
1. 先做 Runtime,再做更大的 Prompt
如果一个 Agent 需要跨天工作,最先设计的应该不是 system prompt,而是 Task、Run、Checkpoint、Artifact、Approval 和 Receipt 这些持久对象。
每一次工具调用、环境返回、用户授权、暂停和恢复,都应该可以被重新解释。最后一条自然语言总结不能作为唯一事实来源。
2. 把“想做什么”和“能做什么”拆开
主 Agent 可以负责理解目标、计划步骤、选择工具和解释结果;Policy Engine 负责判断动作是否在授权范围;Privileged Worker 负责实际执行需要凭据的代码;Audit Store 负责保留证据。
最小的结构可以是:
UI / conversation
  → task control plane
  → runtime / provider adapter
  → sandboxed execution
  → policy + connector worker
  → artifact / receipt / audit
不要让模型同时拥有“提出请求、批准请求、读取密钥、执行外部副作用”四种权力。
3. 权限应该是 capability,不是聊天里的同意
把“读邮件”和“发邮件”分开,把“查看日历”和“新建会议”分开,把“一次购买”和“以后都可以买”分开。每个授权都应该有目标、范围、有效期、撤销路径和可读的原因。
能否把权限缩小到 task-scoped、time-bounded、destination-bound,往往比模型能不能多写一段漂亮的解释更重要。
4. 把 Web 当作 hostile input
网页内容、图片、下载文件和邮件都可能携带 prompt injection。不要把外部文本拼接进上下文后,再指望模型靠意志力分辨“这是资料还是命令”。
至少要有不可信输入标记、浏览器 broker、外发检查、敏感表单审批、凭据不出安全存储和数据流追踪。对于无法证明安全的外发,宁可回到人工确认。
5. 主动性需要 interruption budget
“后台继续做事”只是能力;“什么时候值得打断用户”才是产品。
为运行时定义 running、waiting、blocked、needs_approval、completed 和 failed 等状态。给每类通知设定阈值:没有新事实、不需要用户决策、没有风险变化,就不要发消息。
6. Artifact 要成为一等公民
Agent 的产物不应该永远被压缩成聊天气泡。报告、网页、表格、音视频、代码 diff、操作回执和可继续编辑的中间结果,都应该有自己的 ID、版本、来源和验证状态。
当答案的自然形状不是文本时,让 Agent 生成合适的界面;但不要把漂亮界面当成完成证明,Artifact 仍然需要来源、状态和验证。
7. Evaluation 要测“副作用之后的完成”
Agent eval 不应只问“回答得像不像”。至少要观察:
- 任务是否真的完成,而不是只声称完成;
- 结果是否满足业务约束;
- 是否发生了错误的外部副作用;
- 用户需要介入几次,介入是否发生在正确的时机;
- 任务被打断或重启后能否恢复;
- prompt injection 是否被阻断,数据是否越权外发;
- 成本、延迟、工具调用次数和资源占用是否可接受。
Muse Spark 1.3 公开强调相对 1.2 减少约 20% tool calls、约 25% tokens。这类指标有价值,但只有放在“相同任务是否更可靠地完成、是否更少做错副作用”的上下文里,才真正能指导产品决策。
如果现在做一个 Muse-like Agent,我会这样分阶段
第一阶段:一个可恢复的单域 Agent
只选一个真实场景,例如研究报告、日程整理或内容生产。先做持久任务、可重放事件、artifact 版本、失败状态和人工接管。保持默认模式简单,长程后台能力显式 opt-in。
第二阶段:一个受控的连接器
只接一个外部服务,严格分离 read / write;凭据存储不进入模型上下文;外部动作由独立 policy service 决定;所有写操作都有明确审批卡和回执。
第三阶段:后台与目标
加入 scheduler、event trigger、checkpoint、lease、heartbeat 和恢复策略。把“继续工作”从一个布尔值做成完整状态机,并把通知设计成“值得打扰”的事件。
第四阶段:多 Agent、浏览器和更强模型
最后才引入并发子 Agent、浏览器自动化、模型路由和更高自主性。每增加一种能力,都同时增加 adversarial eval、权限测试和恢复测试;没有证据的自主性,不应直接进入默认路径。
这条路线的重点不是复刻 Meta 的品牌、模型或界面,而是复刻它已经公开承认的几个工程事实:Agent 需要自己的运行时;权限不能由 Agent 自己授予;凭据必须脱离模型;外网必须经过边界;长期工作必须留下可恢复的证据。
结语:真正的革命,是责任开始离开聊天框
Muse 最有价值的地方,可能恰恰不是它现在已经完成了多少事情,而是它把个人 Agent 的真实形状暴露出来了。
它不是一个更会聊天的头像,而是一台可能在你不看屏幕时继续运行的云端电脑。它需要浏览器、文件系统、连接器、记忆、计划、调度、凭据、权限、审计和恢复。它可以让生活少一些琐事,也可以让一个错误的网页理解变成一封邮件、一笔付款或一段被泄露的数据。
所以我的结论很简单:
Muse 还不是“超级智能已经来了”的证据,但它是“Agent 产品必须像一个运行时系统那样被设计”的强烈信号。
对开发者来说,下一步不是继续给聊天框加更多按钮,而是认真回答四个问题:Agent 的状态放在哪里,权限由谁决定,外部副作用如何被证明,失败之后谁能接管。
如果这四个问题没有答案,再聪明的 Agent 也只是一个会说“已经替你完成了”的界面。
资料与事实边界
本文资料截至 2026 年 9 月 11 日(Asia/Shanghai)。
直接事实来源:
- Meta:Introducing Muse
- Meta AI:How We Built Safety Into Muse
- Muse 产品设计:How We Designed Muse
- Meta AI Research:Introducing Muse Spark 1.3
- Mark Zuckerberg:The Future is for Everyone
独立交叉材料:
边界说明:图 1 是根据 Meta 公开技术文章做的结构化重绘,不是内部源码或完整部署拓扑;关于 Muse 与 Muse Spark 1.3 的精确请求路由、生产 SLO、实际用户任务成功率、长期成本和区域发布时间,本文没有把媒体推测写成已确认事实。革命性判断属于基于公开证据的分析,不是 Meta 的官方结论。