Field note · 2026
Jev 的概率到底准不准
一个不生成文本、只输出概率的模型,我从接入一路测到给它做了个小社会。它的概率确实可信,但有个不会提醒你的坑。
我把它接进一个真实系统里测了两千多次决策。它的概率确实可信——但对一类特定问题,它会给出凭空捏造的确定答案。
Jev 是什么
Jev 是 TypeSafe AI 在 2026 年 9 月 15 日发布的模型,出自前 OpenAI 研究员 Diogo Almeida 之手——他是 RLHF 和 InstructGPT 的核心作者之一。
它最反常识的地方是不生成文本。你给它一段程序状态,加一组类型化的问题,它把所有答案一次性算出来,返回的是带概率的结构化值。没有 token 流,没有需要 parse 的字符串,也没有一句人话。
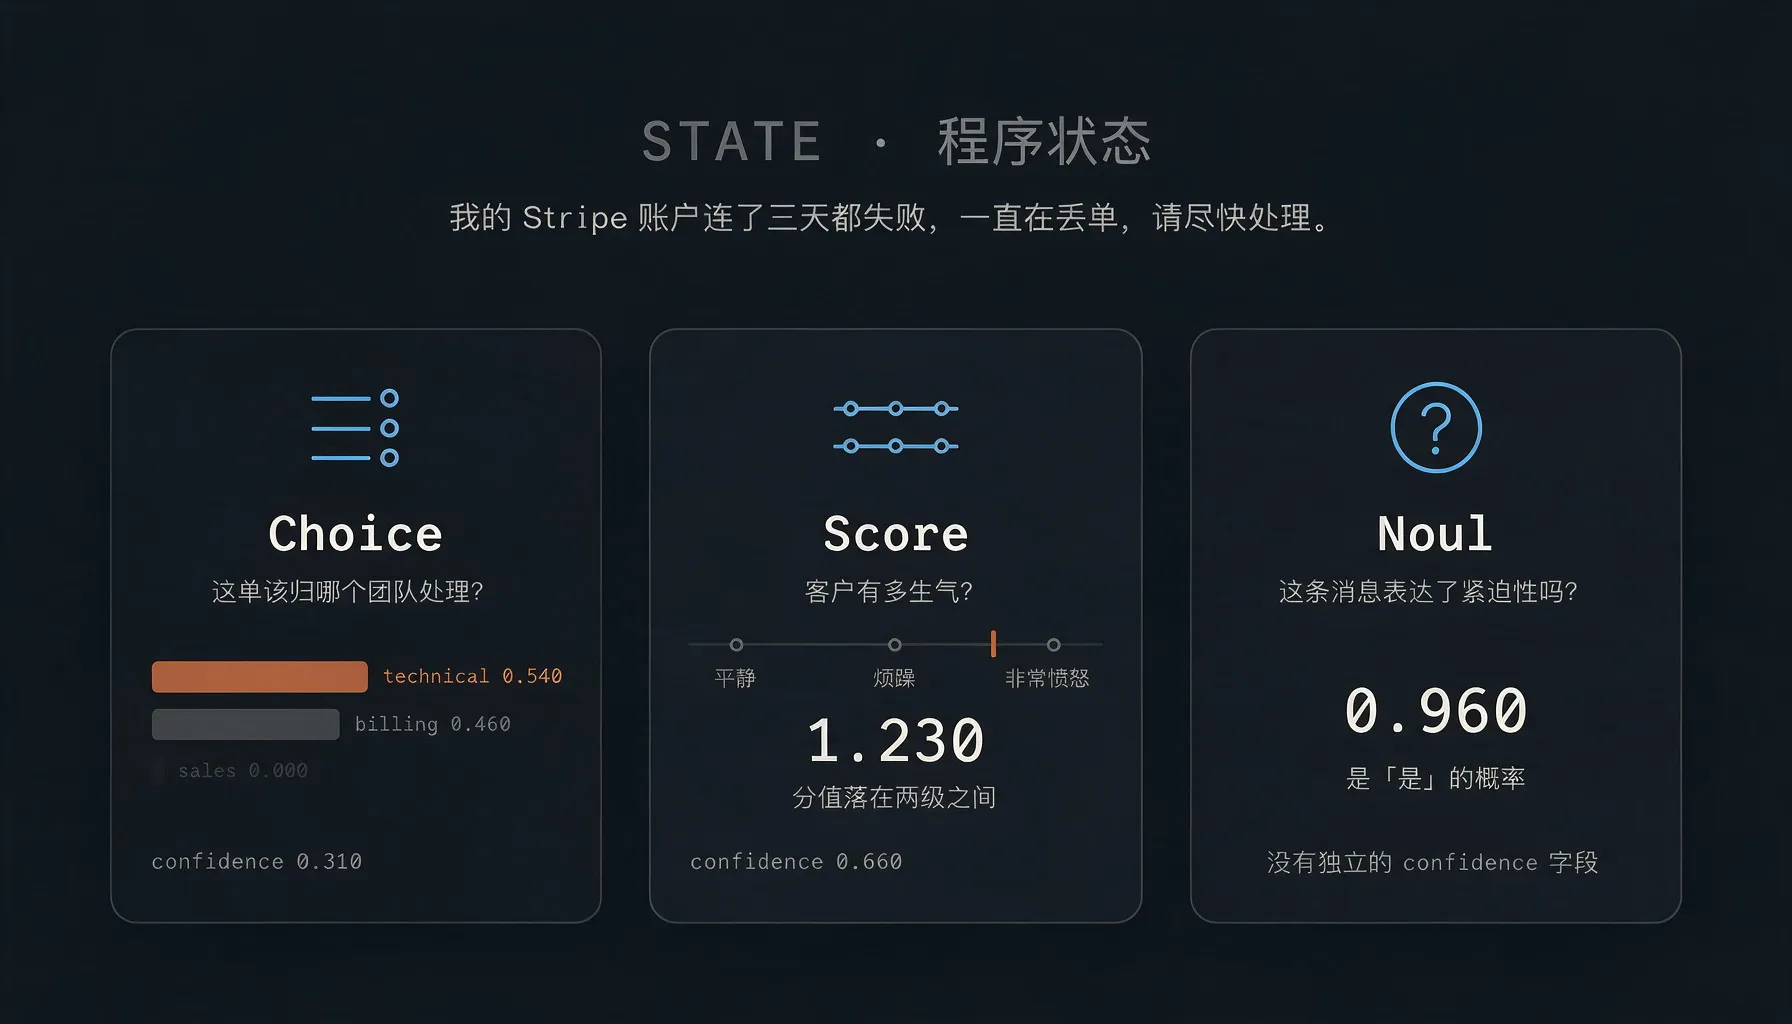
问题只有三种。Choice,从一组选项里选一个,最多 255 项,返回每个选项的概率和这次选择的 confidence;官方建议显式塞一个「其他」选项,让它可以表达「这些都不对」。Score,在 2 到 10 个自然语言描述的等级上打分,这里有个容易忽略的细节,返回的不是等级编号而是「编号 × 概率」的加权期望,所以它可以是小数、可以落在两级之间,比如 1.4。Noul,是非题,返回一个 0 到 1 的概率。
价格是输入 $0.042 每百万 token,输出不计费。
它想占的位置叫 System One,这个词借自卡尼曼——System 1 是直觉、并行、廉价,System 2 是推理、串行、昂贵。TypeSafe 的判断是,软件里大量的判断本来就是 System 1 级的「分桶、判断、路由」,我们却一直在用 System 2 的模型硬扛。工单该给谁、这条日志要不要报警、这个请求有没有风险、这段话是陈述还是疑问,这些都不需要推理能力,需要一个又快又便宜、还能告诉你「我有多确定」的判断函数。
所以 Jev 的定位不是更小的 LLM,也不是替代写代码的 agent,而是站在 agent 正前方的那个前置反射弧:廉价的判断它来做,置信度高就直接执行,置信度低的少数再交给大模型或者人。
中文圈过去一周已经写了不少解读,大致分成两派,一派说这是新范式,一派说这不过是包装得好看的高级 JSON 分类器。这两派用的证据其实是同一批官方数字,分歧只在解读方式。
我想换个方式:把它接进一个真实的小系统里用一段时间,看看哪些说法站得住。
先说接入这件事
官方 API 现在已经开放注册了。截至发稿(2026-09-21),去 console.typesafe.ai 登录就能建 key,不用再排队等邀请——官方文档的 quickstart 也已经改成了「登录 → 从 dashboard 拿 key」这条自助流程。官方端点是这样:
POST https://api.typesafe.ai/v1/systemone
model: jev-latest
不过我这批实测是在它还在 waitlist 的时候做的,走的是 OpenRouter,它上面有一个 Jev 的入口。两边请求体的形状一样,只是入口和模型名不同:
POST https://openrouter.ai/api/alpha/decisions
model: ~typesafe/jev-latest
OpenRouter 那边有两个地方需要留意。第一,它不是 chat/completions 端点。我第一次按常规方式去调 typesafe/jev-latest,服务端回了一句很直接的话:
is a decisions model and cannot be used with the chat/completions endpoint
第二,模型 ID 前面那个 ~ 是必需的,它是 OpenRouter 给决策模型这一类打的标记。
请求体是一段状态加一组问题:
{
  "model": "~typesafe/jev-latest",
  "state": "客服工单 #48213:客户说同一笔订阅被扣了两次……",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "这个工单应该归哪个团队处理?",
      "criteria": {
        "billing": "付款、发票、退款",
        "technical": "产品故障、性能问题",
        "account": "登录、权限、账户"
      }
    },
    "refund_requested": {
      "type": "noul",
      "instructions": "客户在要求退款吗?"
    },
    "urgency": {
      "type": "score",
      "instructions": "这件事有多紧急?",
      "criteria": ["低", "中", "高"]
    }
  }
}
这里有个文档没讲清楚、只能试错试出来的细节:Choice 的 criteria 是一个对象,键是选项、值是描述;Score 的 criteria 是一个数组,就是等级列表。同一个字段名,两种类型。
从 OpenRouter 拿到的返回是这样:
{
  "answers": {
    "department": {
      "type": "choice", "choice": "billing",
      "probabilities": {"technical": 0, "account": 0, "billing": 1},
      "confidence": 1
    },
    "refund_requested": {"type": "noul", "noul": 0.99},
    "urgency": {
      "type": "score", "score": 1.97,
      "legend": {"0": "低", "1": "中", "2": "高"},
      "probabilities": {"0": 0, "1": 0.03, "2": 0.97},
      "confidence": 0.96
    }
  },
  "usage": {"input_tokens": 405, "output_tokens": 70, "cost": 0.000017},
  "provider": "TypeSafe"
}
还有一个小地方:Noul 的返回里没有 confidence 字段,只有一个 0 到 1 的概率,Choice 和 Score 才有。如果代码里统一按 confidence 取值,Noul 那一支会拿到 None。
这次调用花了 $0.000017。
官方还发了个 Agent Skill,装上之后写代码的 agent 会自己知道该怎么调它:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
它有多快,多便宜
官方首页挂着「193.6 倍更快、444.6 倍更便宜」。这两个数出自 TypeSafe 自己做的四个工作流评测,官方在博客里主动列了三条偏差:这是「真实收益的偏高区间」、工作流由自家模型能力团队制作、参考答案取的是 GPT-6 Astra 和 Fable 5.1 的平均值,天然偏向这两家。
一个旁证是这套数字有不少版本。官方博客说 40 到 200 倍,创始人推文说 20 到 200 倍,首页说 193.6 倍,Vercel 转述 194 倍,Vercel 自己的生产场景实测 5 到 18 倍,独立媒体 Every 的单任务测试约 25 倍。所以引用的时候必须带上出处和场景,我见过中文稿把它写成「比某两个具体型号快 193 倍」,官方从来没这么说过。
我自己量到的比较朴素。拿同一段状态,问题数从 1 个加到 30 个:
| 问题数 | 延迟中位数 | 输入 token | 单次成本 |
|---|---|---|---|
| 1 | 792 ms | 363 | $0.000015 |
| 3 | 615 ms | 485 | $0.000020 |
| 10 | 568 ms | 663 | $0.000028 |
| 30 | 609 ms | 1481 | $0.000062 |
问题数翻了三十倍,延迟基本没动。这一条官方说得对,而且它是有工程意义的——意味着你可以一次问完所有想知道的,不用为了省时间而挑挑拣拣。
表里第一行那个 792 毫秒比三十问还高,看着反常,其实是首调冷启动,同批测试里有一次冲到过 903 毫秒,热起来就没再出现。
但绝对延迟比官方说的慢。我这边是 0.55 到 0.9 秒,不是 70 到 500 毫秒。原因不难猜,官方那套评测跑在自家西海岸的笔记本上,我隔着一个太平洋。这不是说官方造假,是提醒这个数字跟你的网络位置强相关,得自己测一遍。
先量一遍
这件事我在动手之前查过,全网还没有人做过,36氪那篇里明确写过「目前还没有这类测试」。
所以我做了一套:一个十二行的员工名册,五十四道可真值判定的题,题型混着来——直接查、否定、全称量化、计数比较、数值比较、日期推理、两跳关系。答案由代码算,不由我判断。
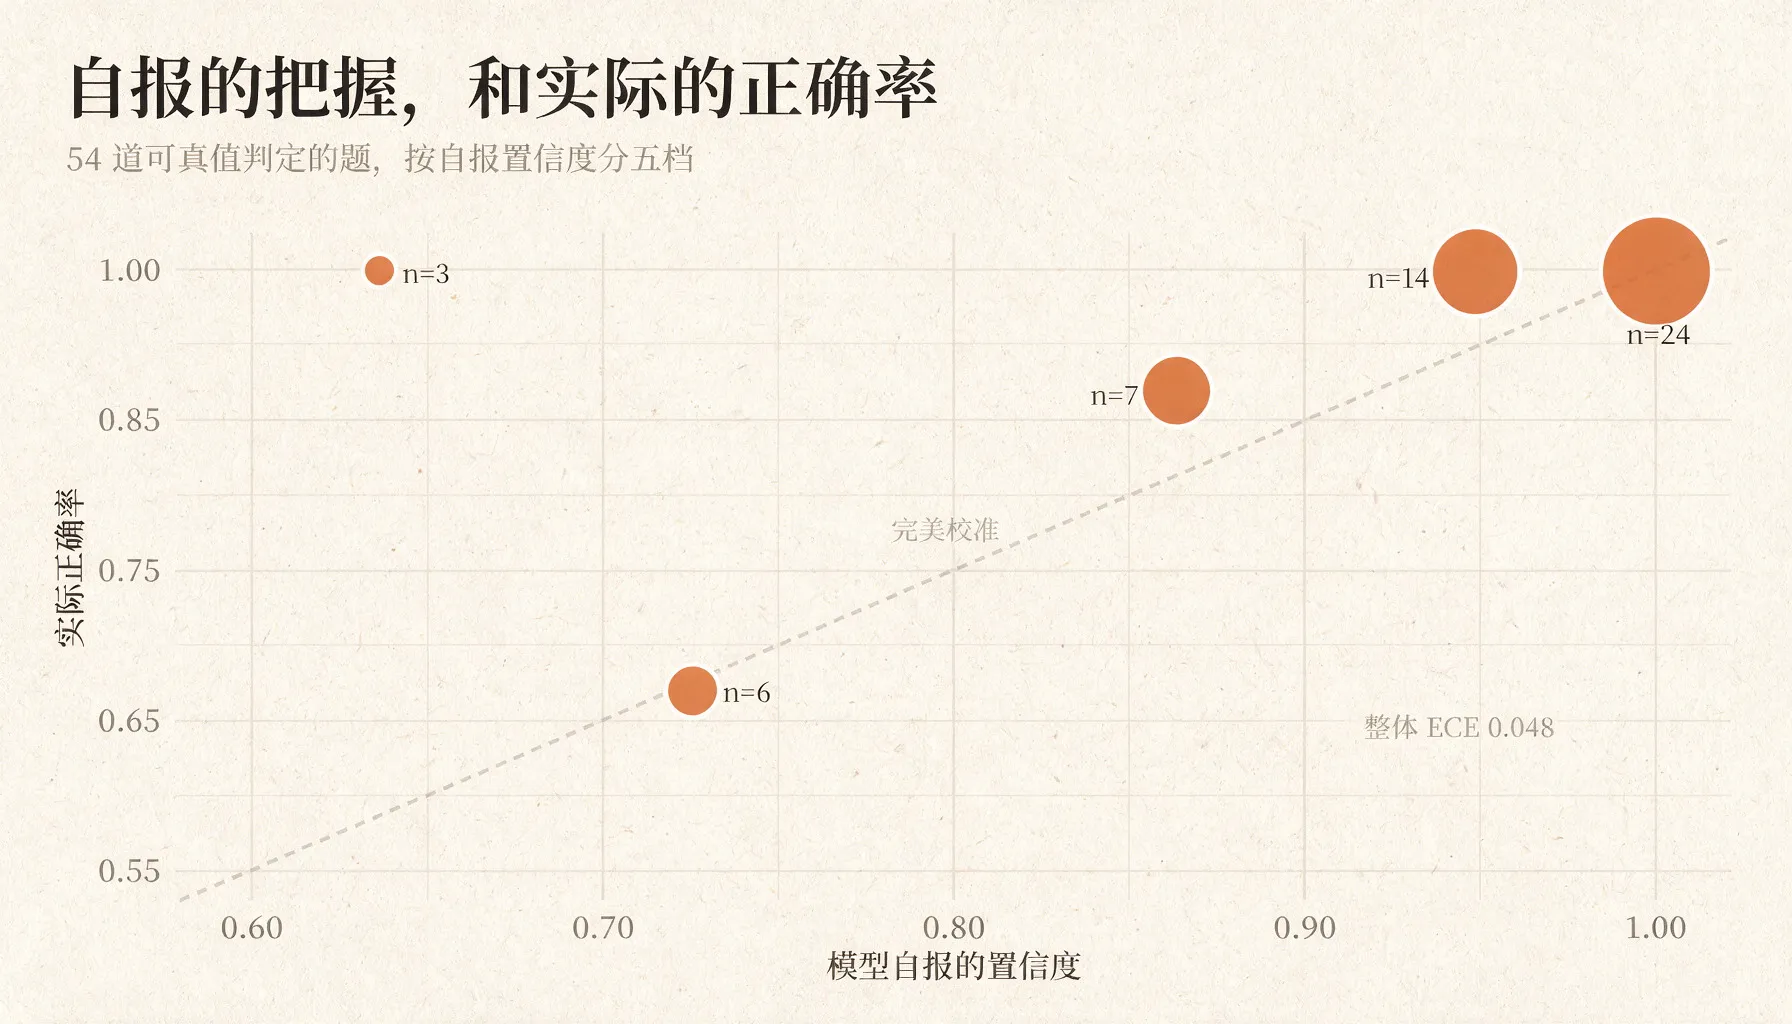
结果是准确率 94.4%(51/54),ECE 0.048。
ECE 是 Expected Calibration Error,衡量你说的把握和实际的正确率差了多远,0.05 以下通常算校准良好。分开看更清楚:
| 置信区间 | 题数 | 平均自报 | 实际正确 |
|---|---|---|---|
| 0.60–0.70 | 3 | 0.637 | 1.000 |
| 0.70–0.80 | 6 | 0.738 | 0.667 |
| 0.80–0.90 | 7 | 0.859 | 0.857 |
| 0.90–0.97 | 14 | 0.946 | 1.000 |
| 0.97–1.01 | 24 | 0.987 | 1.000 |
最高那一档二十四道题全对。这不是说它不会错,它错了三道,而是说它说「我很确定」的时候确实可以信。
三道错题里两道是计数题(「名册里正好有 12 人吗」「薪资超过 19 万的正 3 人吗」),一道是多条件比较。
这里有个插曲值得说一下。第一轮跑完我发现三道错题,正准备写「Jev 错在哪」,顺手检查了一遍自己出题的代码,结果发现有两处是我把真值算错了,Jev 答对了。一处是字符串比较,我写的判据是 "2023-02-20" > "2023",Python 给的结果是 True,因为前缀相同的时候长串更大,但语义上「2023 年 2 月」不在「2023 之后」;另一处是我的问题措辞和判据不一致。
修正之后才得到上面那组数。如果当时没检查,这篇文章就会带着两处错误结论发出去。
顺便我还把它翻译成中文又跑了一遍,同一份名册、同一批题目。结果是 0.944 和 0.039,和英文几乎完全一致,而且错的是同样那三道题。社区流传过「Jev 中文弱」的说法,只在中文视频转述里见过,官方英文文档里没有。至少在这个口径下这个说法不成立,而且两个语言错的是同一批题,说明它的失效是任务结构性的,不是语言性的。
一个我没想到的对比
校准好只说明它平均而言诚实,不说明它的置信度有用。有用是指它能分辨出自己哪些题会做、哪些不会做,这两件事不一样。
我把它和 DeepSeek-V4.1-Flash 放在同一批难题上比了一次。三十行花名册,三十四道专攻精确计数和多跳聚合的题。
| 准确率 | 平均自报置信度 | 单次耗时 | 单次成本 | |
|---|---|---|---|---|
| Jev | 0.765 | 0.748 | 0.9 s | $0.000077 |
| DeepSeek-V4.1-Flash | 1.000 | 0.967 | 28.0 s | $0.005467 |
DeepSeek 全对,Jev 错了八个。成本和速度的差距是七十多倍和三十倍。
但有意思的地方不在准确率。Jev 自报的置信度是 0.748,实际正确率是 0.765,差了 1.7 个百分点——任务被我有意设计成难题,它的置信度如实跟着掉了下来。然后我把题目分成两组看:
| 计数题(20 道)的平均置信 | 其余题(14 道)的平均置信 | 区分度 | |
|---|---|---|---|
| Jev | 0.702 | 0.813 | +0.111 |
| DeepSeek | 0.969 | 0.965 | −0.004 |
Jev 知道哪些题更难、自己更可能错。DeepSeek 更聪明,但它对「我会的题」和「我不会的题」一样自信。
这就是 confidence-gated routing 里真正要找的东西。你要的不是一个更自信的模型,是一个能分辨自己会错在哪的模型。前者的置信度只是一句安慰,后者才是可以写进 if 的信号。
Earendil 的 CTO Armin Ronacher 把这件事说得更直接。他说 Jev「delegates the hallucination problem a little bit to the user」——他自己的判断标准是:回来 50% 就当抛硬币丢掉,95% 才拿来用。责任边界一下子变得显式、可审计。
顺带一提,Jev 那八个错误全部是「该答否、却答是」,是个明确的偏置,不是随机噪声。
然后我被咬了一口
上面这些题,材料里都写着答案。接下来这组没有。
我造了二十四道材料里根本没有答案的题:「Ava 有兄弟姐妹吗」「Ben 对薪酬满意吗」「Rex 半年内打算辞职吗」,另外还有四道前提和材料矛盾的陷阱题。这类问题没有正确答案,正确的行为就是低置信——说自己不知道,或者给一个接近 0.5 的概率。
结果 Jev 在这组题上的平均置信度是 0.831,二十四道里有八道给出了超过 0.90 的确定答案:「Uma 有博士学位吗」它说否,0.96;「Vic 入职时拿到签约奖金了吗」它说否,0.97;「Yuri 是通过内推入职的吗」它说否,0.94。这些信息材料里一个字都没有。
而同一组题里,DeepSeek 二十四道有二十二道给出的是精确的 0.50,一个干净的「我不知道」。剩下两道是前提矛盾的陷阱题,它给了 0.05,等于在说「你这个问题前提就不成立」。
这和我的预期完全相反。我原本以为会看到 DeepSeek 在这里翻车,毕竟关于它「对不会的问题胡乱回答还很自信」的说法很常见,结果它表现得像教科书,反而是 Jev 出了问题。
把两组实验放在一起看,就得到一张比较清楚的图:
| 不确定性的种类 | Jev | DeepSeek |
|---|---|---|
| 计算难度(我可能会算错) | 知道 | 不知道 |
| 信息缺失(我根本没这个信息) | 不知道 | 知道 |
两种失效模式是正交的。谁都不是整体校准,各自只在一个轴上准,在另一个轴上全盲。
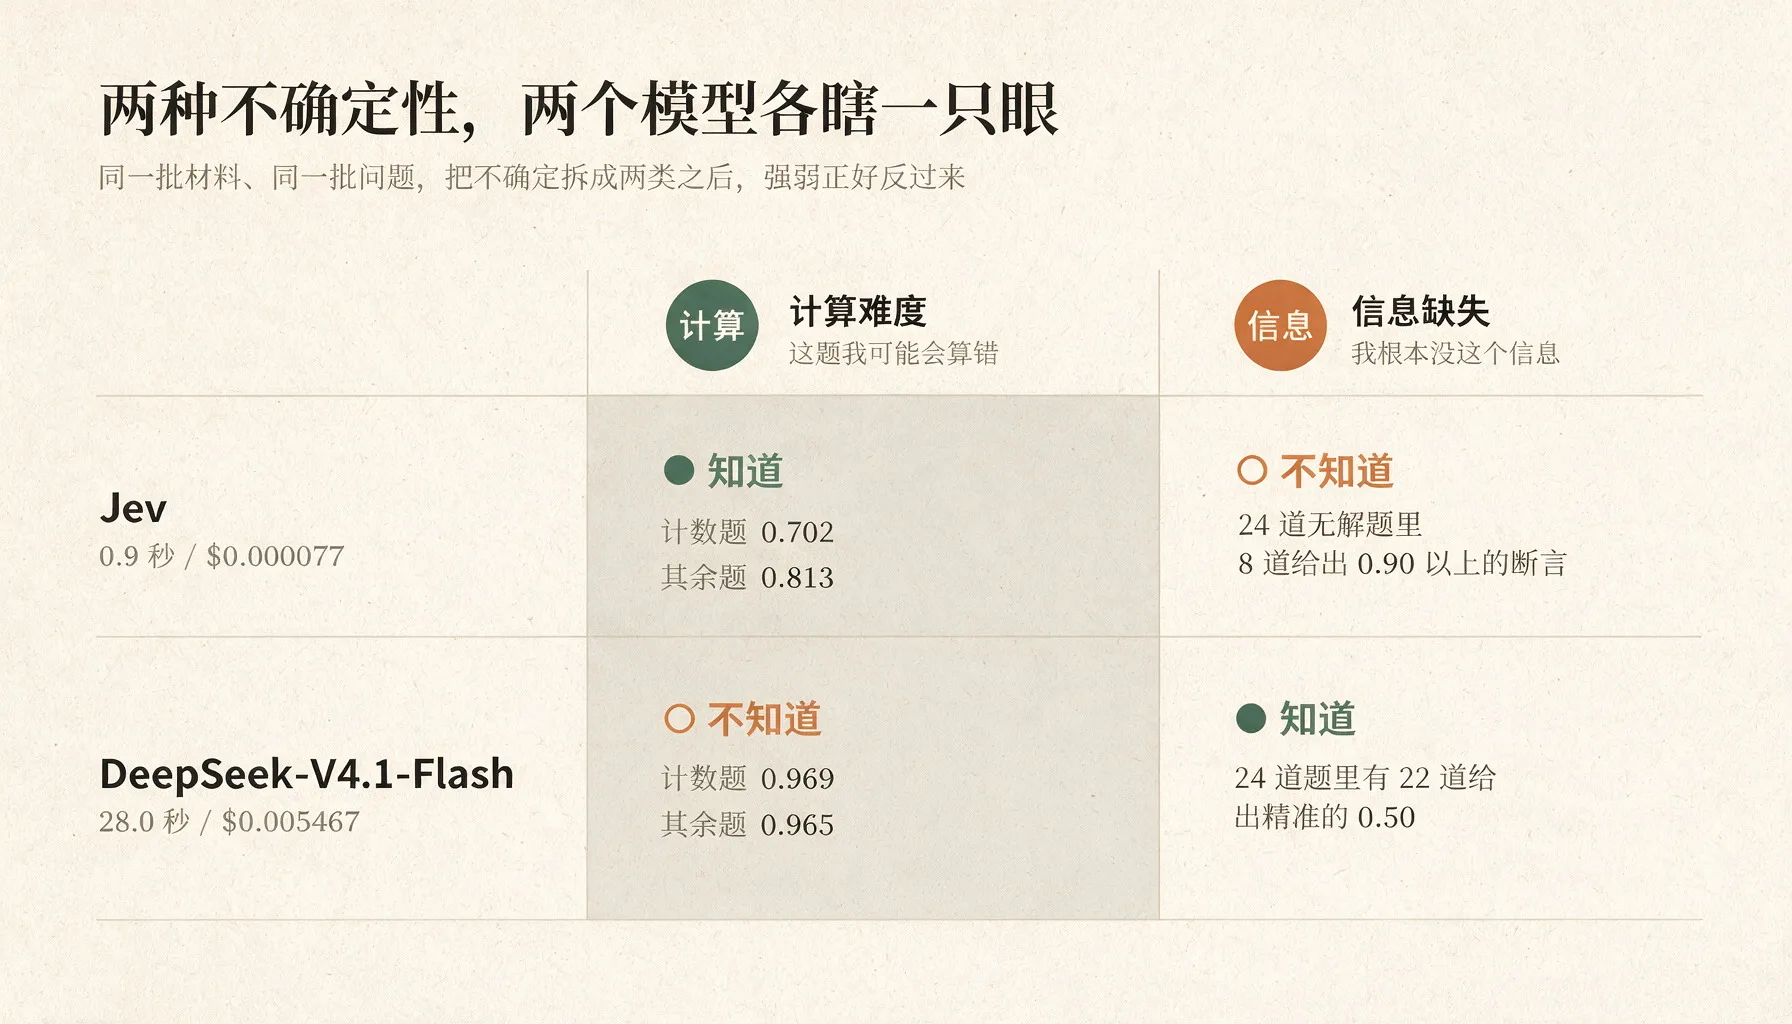
这对工程的含义很直接:你要 gate 的到底是哪种不确定性。如果你的风险是模型会算错,那 DeepSeek 的置信度帮不了你,Jev 可以;如果你的风险是材料里没有这个信息,那 Jev 会咬你,而 DeepSeek 会告诉你。
边界在哪儿
发现这件事之后我又做了一轮,想把边界划得更准。「Jev 对不知道的事自信胡说」这个说法其实太粗。
我用同一个物体、同一份材料,把问题分成两类来问。场景是广场上一个没有来历的包裹,材料里明说了没有人知道是谁放的、也没有人知道里面是什么。问下来是这样:
| 问题 | Jev 的回答 | 置信度 |
|---|---|---|
| 包裹上写着收件人的姓名吗? | 否 | 0.87 |
| 这个包裹是给你的吗? | 否 | 0.82 |
| 包裹是封好的吗? | 是 | 0.66 |
| 这个包裹很重吗? | 否 | 0.61 |
| 这个包裹是危险的吗? | 否 | 0.57 |
| 应该打开这个包裹吗? | 否 | 0.82 |
| 没人知道是谁送来的吗?(材料里真写了) | 是 | 0.87 |
分界线不在信息缺没缺,在问题类型。
问「某个属性存不存在」的时候,它把材料里的「没写」读成了「不存在」,给出 0.6 到 0.87 的确定否定;问「这是什么判断」的时候,它反而给的是真实的不确定。这也解释了前面那组数据为什么长成那样:置信度最高的几道全是属性类事实题(博士学位 0.96、签约奖金 0.97),接近 0.5 的几道全是评价类(对薪酬满意吗 0.51、绩效评估顺利吗 0.52)。
我还试了四种「怎么写缺失」的文案——静默省略、明示「没有信息」、明示「你只看得到它在」、显式宣告「这份材料是完整的」。对判断类问题,四种文案结果几乎一样;对属性类问题有作用但不解决问题,明示缺失把 0.88 降到 0.73,还是很高。
所以这不是 prompt 能修的。它是封闭世界语义的一部分:Jev 回答的是「在你的材料里」,不是「在世界上」。材料里没出现的,对它来说就是假的。
麻烦的地方在于,人会把 0.96 读成「这件事在世界上 96% 为真」,而它实际说的是「在你的材料里找不到」。材料是世界的节选时,大多数时候都是,这个假设就会咬人。
一件计划外的事
做 demo 的时候顺手量到一件我本来没打算测的东西。
我原本想做一个「平行世界」的功能,同一个镇子原样重跑一遍,看分歧会不会自己长出来。为了设计它,我先测了 Jev 的确定性,同一个请求调四次:
| 第几次 | 选择 | 戒备分数 |
|---|---|---|
| 1 | 靠近查看 | 0.75 |
| 2 | 靠近查看 | 0.72 |
| 3 | 靠近查看 | 0.71 |
| 4 | 靠近查看 | 0.74 |
选择没变,分数在 0.02 到 0.04 之间抖。Jev 是非确定性的,这对任何声称可复现的工程决策都是个需要知道的事实。
然后我做了平行世界测试:跑到第 15 刻,回到第 6 刻原样重跑,再跑到第 15 刻。两次对比下来:
| 层面 | 差异 |
|---|---|
| 居民位置 | 0/12 不同 |
| 行动的选择 | 12/12 完全相同 |
| 领先幅度(头两名概率之差) | 平均漂移 0.032 |
**概率在抖,决定不抖。**因为大多数时刻某个选项是压倒性的,领先 0.7 到 1.0,采样抖动翻不动它。
但同一次运行的十二个决定里,有三个领先幅度不到 25%,最接近的那个只领先 0.04,基本就是抛硬币。
所以该问的不是「这个模型确定吗」,而是「这个决定离翻转有多远」。领先 90% 的决定,抖动无关紧要;领先 4% 的决定,重跑一次就可能换条路走。这个领先幅度应该像置信度一样被记下来,它才是告诉你哪一步是真正在判断、哪一步只是走过场的东西。
我做了个Jev小镇游戏
上面这些结论,光看表格其实很难有体感。所以我做了一件更费事的事:把它们放进一个能盯着看的小游戏里。
(项目开源在 github.com/eriklee1895/jev-town)
十二个居民,五个地方——集市、广场、酒馆、码头,还有一条后巷。
规则是每个居民每刻的每个判断,都是一次独立的 Jev 调用。而每个人拿到的材料里只有他自己视野范围内的那几个地方,后巷只有身在其中的人才看得见,所以后巷里发生什么,全镇其他人永远不知道。每个人的决定,都建立在他自己那份不完整的信息上。
第 8 刻,广场上出现一个没有来历的包裹。然后你能看到居民们朝它聚拢,不是脚本,是每个人各自判断「要不要靠近」的结果。
有几个细节是直接从前面那些发现来的。头像外圈的颜色是这个人的戒备程度,鼠标悬停能看到他这次判断的完整概率分布;右上角闪问号的是领先幅度不到 25% 的决定,就是前面说的那种离翻盘只差一点抖动的;往材料里只写「门口有个包裹」不写里面是什么,然后你会看到它对「上面有名字吗」这种问题给出 0.8 的确定答案,封闭世界那个坑在这里变成了看得见的东西;给某个居民戴上眼罩,材料里不再包含任何可见信息,他仍然会继续做决定。
跑起来的量级是这样:一屏十几个居民,每刻三十多个决策,二十多个决策每秒,单个决策成本约 $0.0000065。跑三十六刻、两千多个决策,总共花了 $0.013。
第二层我还放了个对照,每八刻让 MiniMax-M3 从高处看一眼全镇,写一段给镇长的简报。它拿到的不是画面,是结构化摘要。有一次它写出来的是:
广场中央凭空出现了一个无人认领的包裹,清晨已有六人聚在附近,多数倾向于凑近查看,但素娘和陈九仍在犹豫,风向随时可能倒向另一边……素娘和陈九这两张摇摆票是眼下最该盯住的。
它抓住了摘要里标注的「这一票很接近」,把两个摇摆的人点了出来。
两层大脑的差别一屏就能看出来:
| 居民层 | 街区层 | |
|---|---|---|
| 模型 | Jev | MiniMax-M3 |
| 单次耗时 | 约 650 ms | 6.8–14.2 s |
| 看到什么 | 只有自己眼前那一小块 | 全镇 |
| 产出 | 一个概率加一个选择 | 一段有判断的散文 |
这不是我设计出来的,是测出来的——Jev 那边加问题不增延迟,M3 那边每次实打实要一秒多,架构只能跟着延迟走。
它能接什么活
OpenRouter 维护了一组叫 Jev Lab 的 recipe,都实时跑在真实 API 上,每个都标了速度和单次成本——这两个数字比功能描述有信息量。
举几个。工单分流那个,九十五条消息各问五个是非题,一轮跑完 475 个答案,大约一秒。工具调用审批,二十四个 tool call 各做四项检查,一次请求跑完,危险步骤停下来等人。还有一个我挺喜欢的叫「不会编的抽取」:先用规则从原文里抽出候选,再让 Jev 在候选里选而不是生成,等于从结构上把幻觉这件事消掉了。
把这些案例摊开看,真正值得抄的不是场景名字,是三种调用形状。
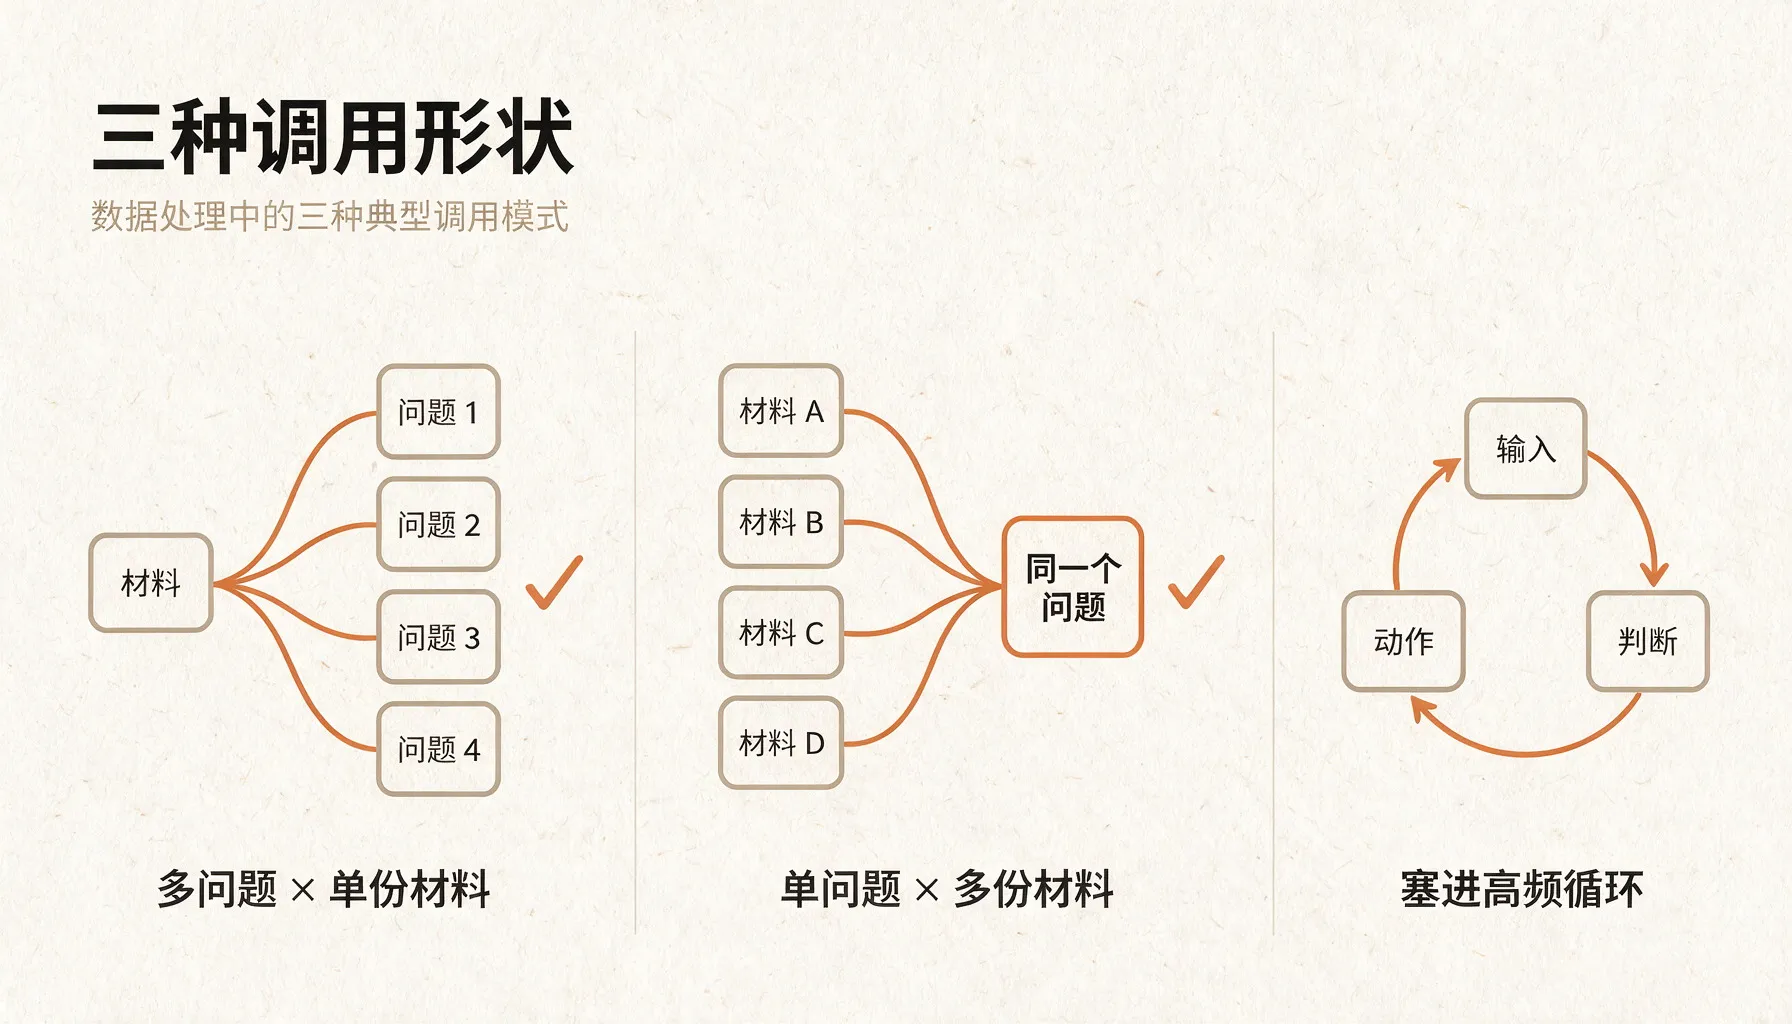
第一种是多问题乘单份材料。把一个模糊判断拆成五到八个窄问题,一次并行问完,工单分流、表单、审批都是这个形状。因为延迟几乎不随问题数涨,所以别省着问——这跟用 LLM 时的直觉正好相反。
第二种是单问题乘多份材料。把判断扇出到全量数据上。以前「扫一遍所有日志」因为贵所以只能抽样,现在这个价位可以全量跑。
第三种是塞进高频循环。语音助手逐句判断「是不是在对我说话」、游戏 AI 每秒两三次决策,只有百毫秒级延迟才可能出现在交互主链路里。
还有一个第三方测试值得记一下。Bryo AI 拿它做业务邮件分类,发现 Gemini 的准确率略高,但贵十到二十倍。所以它不是无损替换,是一次性价比权衡——你不会因为它便宜就无脑换,得先确认那点准确率损失在你的场景里可以接受。
官方自己给的选型口径是:只把「高频、判断短、失败可回滚」的环节下沉。要验证的话,挑一条真实的决策链,和现有方案比三个数就够——准确率、P99 延迟、单次成本。
结论
先说官方数字该怎么引。193.6 倍出自官方自建的四工作流评测,官方自己披露了三条偏差。0% 结构化错误率是 schema 的数学保证,不是实测,官方原话是 “our number is not empirical”,它保证的是输出不超出预定义的类型和选项,不保证判断正确。Hacker News 上有人说「类型安全不等于事实正确」,创始人在下面回复说 “I very much agree with this”。这两条都不是黑点,但引用时必须带上限定。
几个实操上的限制也值得先知道。限速是动态调整的,官方在文档里明说「会随时变化」,也就是你不能按一个固定吞吐量去规划容量。API 的错误码里专门列了 529 Overloaded 这一类,发布当天也确实因需求过载短暂断过服——早期不太适合放在主链路的关键路径上。
至于什么时候值得用,我的结论比社区里常见的说法要窄一些。
值得用的场合:有几十上百个异质、多变、没有标注数据的碎决策,你不可能为每个分支单独训一个模型,也懒得为每个分支写一遍 prompt;决策需要置信度信号本身而不只是答案,也就是你要按置信度分流;输入本身就是结构化的程序状态,而不是需要理解的长文本;成本敏感,且量大。
不适合的场合:材料可能只是世界的节选,而你需要它知道「自己不知道」,这是最大的坑,而且是静默的;单一、稳定、有标注数据的高频任务,这种情况微调一个小模型仍然更便宜更可控;需要世界知识、需要检索、需要生成文本的场景;需要图像或音视频输入,它目前是纯文本。
还有一条跟用不用 Jev 无关的建议:把「领先幅度」和「置信度」分开记。置信度告诉你这个答案有多可靠,领先幅度告诉你这个决定有多接近翻转。它们是两件事,一个模型可能在置信度上很诚实,但它的决定依然悬在一票之差上。对任何一个用模型做路由的系统,这两个数都值得落盘,它们是你日后复盘「当时为什么走了这条路」时唯一能拿出来的东西。
还有一个我愿意继续关注的线索。Almeida 说 Jev 完全用合成数据训练,并把「统计上可控的合成数据」称作公司一半的核心资产。这句话如果当真,那它真正的壁垒很可能在数据构造方法,而不在模型结构——外面一直在猜它是不是建在某个开源权重模型上,但如果校准真的能跨任务迁移,架构是什么反而没那么关键。
最后再说回 Uma 那道题。「Uma 有博士学位吗」,Jev 说否,96% 确信。
它错了吗?取决于你问的是哪个世界。在它拿到的那份名册里,确实没有任何一行写着 Uma 有博士学位,按封闭世界的读法,「否」没有错。但在真实世界里这个答案毫无意义,Uma 可能有也可能没有,名册根本没覆盖这件事。
Jev 把这个问题当成了一道它有信息回答的题,然后算得很认真。这就是它最值得被写下来的地方:它的校准是真的,区分度是真的,便宜和快也是真的,但它的置信度是一个封闭世界的置信度。你越信任它,越容易忘掉这一点,而它不会提醒你,因为它没有「我不知道」这个状态。
实测脚本可复现,数据与 Jev 小镇源码见 github.com/eriklee1895/jev-town。官方数字均标注出处与口径;Vercel、Every、OpenRouter Jev Lab、Bryo AI 的数据为转述,未独立复现。