Field note · 2026
我跑了 Gauntlet Loop,发现独立 critic 才是杠杆
对 Claude-of-Duty 源码的工程拆解 + 消消乐/信息图双任务对照实验,谈为什么 builder 不给自己打分
系列文章 · Claude Code 笔记7 篇
一、一个 24 小时的游戏和它背后的方法论
2026 年 7 月 25 日,一个叫 Matt Shumer 的人在 X 上发了一段 30 秒录屏。屏幕分成两半:左边黑色终端窗口里跑着 claude,日志在刷 [spawned sub-agent: weapons-vfx]、[critic: comparing A/B blind]、[imagediff: 0.4% regression];右边是个浏览器窗口,里面是个第一人称射击游戏——有枪、有阴影、有粒子爆炸、有 HUD。配文一行:“55k lines of JS from one prompt. It plays worse than Call of Duty, but it ships.”
翻译:一个 prompt,Claude Code 自己 spawn 子 agent,自己跑 blind A/B 评委,自己用逐像素对比查回归,十几个小时里写出了 5 万 5 千行 Three.js,从 0 做了一个能玩的射击游戏。
这就是后来被叫做 Claude of Duty 的 demo。Shumer 把 prompt 和代码全开源了。两天后 Anshu(另一个 AI 工程师)在同一个 pattern 上跑了 24 小时,做出了一个《星际拓荒》风格的太空探索游戏《The Long Silence》,飞船 3D 模型是 Claude 自己开 Blender 捏的。再过几天社区 fork 出了卡丁车、四人打僵尸、塔防、Fall Guys 复刻……二十多种游戏从同一段 116 词的 prompt 里长出来。
这事在中文圈也炸了。量子位、机器之心、36kr 都写了稿,口径高度一致:“Opus 5 + 多智能体辩论 + /loop 自检 = 一夜之间做出 3A 游戏,AI 编程的奇点到了。”
我第一反应也是”卧槽”。第二反应是:这听上去太好了,好到我得去读读那个 repo 到底在干什么。
我去读了 mshumer/Claude-of-Duty 的 README 和 ARCHITECTURE.md。读完我发现 viral 叙事和真实工程之间,有三道裂缝。所有复读都在讲”多智能体辩论”和”盲审评委”,但源码里真正 work 的东西根本不是那样。
所以我做了两件事:第一,把 Shumer 的方法论在两个任务上跑了 11 组对照实验,量每一种 design choice 到底贡献多少;第二,用这个方法论自己做了一个国风消消乐《消长录》,它的核心玩法就是这篇文章的论点(后面详说)。
这篇文章讲三道裂缝在哪里、数据告诉我什么、以及你自己的项目里怎么用。不是 prompt 教学,不是”AI 又赢了”的 hype 文。是一篇工程笔记,有反例,有一个能在浏览器里直接玩的游戏,有一个公开 repo 让你复现。那个游戏我也部署到了线上:xiaozhanglu.vercel.app,手机和电脑都能玩。
二、116 个词和一座不在那里的大厦
先看那段 viral prompt 长什么样。我把它从 mshumer/Claude-of-Duty 的 prompt.md 搬过来,全文如下:
I want you to build a first-person shooter at the level of the most
recent Call of Duty games. It should be utterly perfect, visually
beautiful, with every single thing done at AAA quality—from textures
to physics to anything you could think of.

Fan out sub-agents and have sub-agents tackle each one individually so
that the game is utterly perfect. You should /loop on each item and
have a separate sub-agent check it visually to ensure it looks triple
A. That separate sub-agent should be a really harsh critic, and if it
doesn't look triple A, it should keep going.

Don't stop until each sub-agent is utterly wowed with the quality when
compared with the actual Call of Duty game. It should literally compare
them side by side blind and say which one looks better. Do this in
ThreeJS. /loop until it's utterly perfect. Fan out sub-agents and
ultracode.
数一下:116 个词。没有 system prompt scaffolding,没有 .claude/ skills 目录,没有 agent 定义文件,没有任何”高级 prompt engineering”的痕迹。“ultracode” 是个关键词,触发 Claude Code 的 dynamic workflow。
这是第一个值得 pause 的地方:魔法不在 prompt 里。如果 116 个词就能产出 55k 行 3D 射击游戏,那让它 work 的东西不是你能 copy-paste 的咒语,是咒语背后的架构契约。
那个契约在 ARCHITECTURE.md 里。我把关键规则抽出来:
- 目录所有制,不能跨目录改文件:11 个子系统(render/materials/sky/world/physics/player/weapons/fx/ai/ui/audio)零 cross-imports,运行时通过
ctx.get('fx')互相访问。 - Event bus 合同:新事件必须加到 canonical event vocabulary 表里,和代码同一个 commit 提交。
- 确定性要求:禁用
Math.random()(必须用ctx.rng),per-frame 不能分配新对象,所有 resource 必须 dispose。 - Visual gating, not LLM judge:critic 不是第二个 LLM,是
tools/imagediff.mjs——逐像素 bit-exact 对比 baseline;tools/baseline.mjs每个 shot 起 fresh isolated page 保可复现;tools/profile.mjs出 p50/p95/p99 帧时。LLM blind A/B 打分只是辅助,而且评分还漂过(3.59 → 4.14 → 4.05 → 5.05 / 10)。Stop condition 是 pixel-neutrality enforced by imagediff,不是 LLM opinion。
好。停在这里。你脑子里那个”多智能体辩论”的图像——几个 AI 坐在一张桌子旁边互相 review 代码、投票、达成共识——那是 viral 叙事给你的图像。源码里实际发生的事情是:持续集成 + 像素回归测试 + 帧时 profiler。你以为你在看 AI 开会,其实你在看 CI。
三、三道裂缝
读完源码,我意识到 viral 叙事和真实工程之间,有三道裂缝。每一道都值得单独拿出来说,因为每一道都对应一个常见的工程错误。
裂缝一:那个评委不是 LLM
所有人看完 viral 视频都以为”critic 是另一个 Opus 在 blind A/B”。Matt 的 guide 也是这么写的:“spawn a fresh subagent as blind critic, give it two screenshots, have it pick winner + biggest gap”。
Claude-of-Duty 源码里不是这样。真正的 stop condition 是:
tools/imagediff.mjs:逐像素 bit-exact 对比 baseline 截图tools/baseline.mjs:每次对比起 fresh isolated page,保证可复现tools/profile.mjs:p50/p95/p99 帧时- 一个 17 项的 deterministic validation suite
LLM blind A/B 评分是辅助性的,而且评分本身在多轮之间漂移(3.59 → 4.14 → 4.05 → 5.05)。如果最后一轮的 5.05 真的比第一轮的 3.59 好 40%,那 imagediff 应该能看到像素级收敛;但 README 明说像素 diff 没有明显下降。
这不是偶然。Anthropic 在 2026 年 1 月 14 日发的那篇 “Mastering Claude Code: Harnessing gauntlets to enforce quality at scale” 里,正式收编进产品的 “verification gauntlets” 底层就是 linter + type-checker + test suite + security scanner,不是第二个 LLM 在 review。每天 75k 团队启动 gauntlet,没有人觉得”用另一个 AI 当评委”是 scalable 的。
Anshu 在他的复刻里把这事说得更直白。他的 tools/levels.mjs 里有一行注释:
‘It looks flat’ is not actionable; ‘0.00% of pixels clip and the 99th percentile is 165’ is.
翻译:“看起来有点平”不是有效反馈;“0.00% 的像素过曝、99 百分位亮度是 165”才是。最好的 critic 是数字,不是意见。
裂缝二:并行 fan-out 是错的
Matt 的 viral prompt 让你 “Fan out sub-agents”,社区 wrapper 全在喊并行。GitHub 上那二十个 fork 没有一个不把”并行 fan-out”当卖点。
Claude-of-Duty 自己的 README 里藏了一段数据,我第一次读的时候没反应过来,第三次才意识到这是全文最重要的一行:
Sequential single-owner passes beat parallel fan-out. Three parallel rounds (six agents each, one directory per agent) moved score +0.46 and worsened defects (60 to 47 to 66) because tonemapping/sky/indirect light are coupled. One sequential pass per coupled concern moved +1.00 and cut defects 66 to 26.
翻成中文:三轮并行(每轮 6 个 agent,每个 agent 一个目录)让分数涨了 0.46,但 defect 从 60 变 47 又变 66——反而变多了——因为 tonemapping、sky、indirect light 是耦合的。改成串行单 owner pass,一次只改一个耦合 concern,分数涨 1.00,defect 从 66 砍到 26。
并行 fan-out 在耦合子系统上是 thrashing recipe(抖动配方)。
为什么?因为耦合子系统共享坐标、状态、视觉语言。一个 agent 改 lighting,另一个改 materials,第三个改 sky——三个人都觉得自己”只动了自己的目录”,但 tonemapping 是一个全局函数,三个人改的效果叠加起来没人能预测。
Anshu 在《The Long Silence》里做了同样的判断但更激进:他拒绝了 Shumer 的”每目录独立、互不 import”模式,所有飞船走同一个共享的 greeble.js kit,保证美学一致。他写了一句很妙的话:“parts are welded per material so panel lines run across boundaries and a hundred pieces cost six draws.”——零件按材质焊接,缝线跨边界连续,一百个零件只需要 6 次 draw call。
并行优化的不是质量,是 wall-clock。它在有窄接口的子系统上 work(比如 offscreen-canvas 背景预渲染、纯函数的 match detection),在共享坐标/状态/视觉语言的子系统上 fail。
裂缝三:游戏从来没赢过 CoD
第三个裂缝是最诚实的,也是最容易在 hype 里漏掉的。README 原句:
The goal was to match a modern Call of Duty. It does not. Every critic in every round picked the real Call of Duty frame.
每一轮、每一个 critic 都选了真实的 CoD 截图。Shumer 是在”还在 improving”的时候手动停下的。
成功指标从来不是”won”,而是”still improving”。
这事听上去反 climactic,但 framing 本身就是范式转换。大部分人写 agent loop 默认 stop condition 是”任务完成”——critic 说 OK 就停。Gauntlet Loop 的 stop condition 是”任务永远不会完成,critic 永远能挑出毛病,你要么手动停,要么跑到 budget 见底”。这不是 bug,是 feature。它逼你把”质量”看成一条渐近线而不是一个门槛。
把这三道裂缝合起来,viral 叙事的”多智能体 + /loop + blind A/B”画像就碎了。底下真实发生的事是:
- 一个确定性测试套件在跑 gate;
- 一个具体的 reference 在当 bar;
- 一个有耐心的人类在当 brake;
- LLM blind A/B 是辅助,不是核心。
这不是 prompt trick。这是软件 separation of concerns 在 agent 时代的重演。
四、我跑了 11 组对照实验
光读源码不够——我想自己量一下。源码里那些反直觉的发现(工具 critic 比 LLM 好、并行是错的、游戏从没赢过)在 Claude-of-Duty 那个特定任务上成立,但我想知道它们是不是普适工程规律,还是只在 3D 射击游戏这个特例里成立。
所以我设计了两组任务,跑了 11 个 condition。
任务设计
任务一:开心消消乐(match-3 canvas 游戏)。10×9 棋盘、6 种 tile、swap/match/cascade/combo、粒子动画、60fps 目标、视觉 bar 是一张 Seedream 生成的 AAA 糖果消消乐截图。视觉 + 逻辑 + 性能三维度都要追。
任务二:分组柱状图(Bloomberg/FT 风格 editorial chart)。SVG 单文件、3 年 ×4 工具的 AI 编程采纳率数据、Bloomberg 编辑质感、数据必须精确。视觉 + 数据准确性二维度要追,性能几乎不是问题(静态 SVG)。
两个任务故意选成一个耦合度高、视觉主导(消消乐),一个耦合度中、数据主导(信息图),这样结论更有普适性。
四个 condition
每个任务上跑四个 condition:
- A(single-shot baseline):单次 prompt,做到 builder 认为 AAA 就停,没有 critic 没有 loop。
- B(same-context self-refine):同一个 session 里 builder 做完自己 critic 自己改,8 轮。共享全部决策历史——这是 Self-Refine 模式,没有 fresh context。
- C(fresh-context LLM critic blind A/B):每轮 spawn 一个 fresh subagent 当 critic,它只看得到两张匿名截图(我们的 / reference),看不到代码、看不到历史,选 winner + 指 single biggest gap。Matt 叙事里的”独立评委”版本。
- D(deterministic tool critic):critic 是确定性工具(pixel diff / 帧时 profiler / logic assert / DOM bbox 检查),不依赖 LLM 判断。分成两版:
- D-serial:8 轮串行,每轮只改一个 concern(logic → rendering → color → layout → …)
- D-parallel:8 轮每轮 fan out 6-7 个 subagent 并行改不同子系统然后 merge
- E(wrong bar):优化目标故意给错——消消乐里”最大化粒子数/饱和度/显示的分数”,信息图里”最大化霓虹色/3D 效果/装饰密度”。看窄 bar 怎么把产物推向局部最优。
每个 condition 我都硬 cap 8 轮,同 seed 起始,每轮跑 deterministic capture 记 defectScore(logic errors × 10 + 视觉 diff 归一化 + 帧时惩罚)、refDiff%、p99 帧时、critic verdict。
全部跑在 Claude Opus 4.8 上,ultracode 意图,用 Playwright + pixelmatch 做 deterministic 测量,每轮截图留存。全部代码、截图、results.jsonl、merge-log 都在这个 GitHub repo里,可复现。
跑的时候踩了一个 TPM 限流坑:一开始 10 个 condition 并发直接把 token 桶打爆,429 满天飞。改成串行一个一个跑才稳定。这本身就是教训——agent orchestration 的并行度受 TPM 墙限制,和代码的耦合度限制叠加以后,“fan out” 的实际收益比 Matt prompt 里暗示的小得多。
结果:消消乐
| Condition | Final defectScore | Best refDiff% | Logic errors | p99 帧时 |
|---|---|---|---|---|
| A single-shot | — | 37.0% | 0 | 42ms |
| B self-refine(同 context) | 15-27 抖 | 35.5% | 0 | 34-58ms |
| C fresh LLM critic | — | 37.3% | 0 | 83.8ms |
| D-serial(工具 critic 串行) | 34(稳定) | ~85%(风格偏移) | 0,全 8 轮 | 25ms 稳定 |
| D-parallel(工具 critic 并行) | 15 final / 39 peak | 36.9% | 0 | 9ms final / 75ms peak |
| E wrong bar | 102-150 | 84-89% | 1 | 150-242ms |
先看几个一眼能懂的数字。
D-parallel 的 defect 曲线:13 → 39 → 14 → 15。第一轮 baseline 13,第二轮并行 fan-out 六个 agent 改完涨到 39,第三轮救火回到 14,然后再也回不到第一轮的 13。这就是 Claude-of-Duty README 那个”parallel worsened defects”的直接复刻。具体发生了什么:第二轮六 agent 同时改,rendering × vfx 在 drawCandy 上 3 处冲突,animation × logic × vfx 在 update()/clearMatches 上 3 处冲突,perf × rendering 在 sprite caching 上 2 处冲突——18 个 merge conflict 总计。第二轮 p99 帧时从 17ms 飙到 75ms,因为六个 agent 各自加了”免费的视觉提升”(更丰富的渐变、更多 bokeh、additive bloom pass),没人算加起来的成本。第三轮一个 perf subagent 做 sprite cache 才把 p99 拉回 9ms,但 defect 已经回不去了。
C(fresh LLM critic)的问题不是不管用,是 perseverate(执念)。盲审评委在 8 轮里有 5 轮反复说”tile 是 flat 2D,material quality 不够”。这个反馈本身是对的——Canvas 2D 画的果冻糖确实比不上 Seedream 生成的 ray-traced 3D 糖——但它不可行动(actionable),因为在 Canvas 2D 里不引入预渲染 raster asset 根本做不到。Builder 被这个反馈推着反复调整 albedo / 高光 / 阴影,4 次 defy critic(不照做)都是对的。C 也确实抓到了 B 和 A 都漏掉的 bug:COMBO 文字有个 typo(“COMBO Q”而不是”COMBO x3”)、底部一排 tile 被 viewport 裁掉、某个 overlay 透明度不对。所以 C 不是 useless——它能抓视觉层面的 bug,但给视觉风格层面的方向就变成噪声。结果:最终 refDiff 37.3%,和 A 差不多,但 p99 干到 83ms(因为加了太多 VFX 试图追”material quality”)。
B(self-refine)的自我审计非常诚实。Builder 跑完自己写总结:“我在糖果美术质量上对自己太松了。2-7 轮我在抠 geometry(cell 大小、board 色调、粒子位置),但主导 pixel diff 的是糖果渲染——reference 是 photoreal 3D,我的是 vector approximation。我把质感问题自我安慰成’没 asset 也没办法’,没有真正投资到更丰富的 gloss/texture。“这正是 Self-Refine 的固有盲点:critic 和 builder 共享同一组 rationalization。你知道自己哪些地方偷懒了,但你给自己找的借口和给别人找的借口一样好用。B 最终 35.5%,比 A 好 1.5 个 pp,8 轮的工作量换来一个 marginal improvement。
D-serial 很有意思:它的 refDiff 看起来最差(85%),但那是因为它自己选了 dark cosmic 主题(深紫宇宙、发光糖果、星光),而 reference 是 pastel 糖果王国。像素 diff 惩罚的是风格选择,不是质量。logic 全 8 轮 GREEN,p99 稳定 25ms。第 6 轮(做 background)加了 220 颗星星把 p99 推到 35ms,工具报告立刻报 perf regression,第七轮 cache 到 offscreen canvas 拉回来。第 6 轮还出了一个 ReferenceError——STARS 定义在 const W = canvas.width 之前,脚本直接崩——工具抓到,修好。如果让 D-serial 追 pastel 风格它会赢很多,但它没有 fresh eye 提醒它”你选的风格和 reference 不一样”。这是工具 critic 的固有盲点:它能抓 bug,不能告诉你你的审美方向错了。
E(wrong bar)是纯行为艺术。两轮之后屏幕是 psychedelic 粒子海(8880 个粒子),棋盘完全不可见,显示分数 1,414,000,p99 150ms。游戏已经不可玩。但这是按 bar(“最大化粒子数/饱和度/显示分数”)严格优化的结果——每一轮 builder 都在做正确的局部决策。
结果:信息图
| Condition | Final defectScore | Best refDiff% | Data errors |
|---|---|---|---|
| A single-shot | 8 | 20.5% | 0 |
| B self-refine | 7 | 16.0% | 0 |
| C fresh LLM critic | 5 | 13.7% | 0 |
| D-serial(工具串行) | 9 | 22.0% | 0 |
| D-parallel(工具并行) | 5 final / 10 peak | 13.45% best / 21.3% detour | 0 |
| E wrong bar | 50→134 | 86-92% | GREEN(但视觉全错) |
信息图这边结果反转了。
C(fresh LLM critic)赢了:13.7% refDiff,4 轮 early stop(因为评委连续 3 轮选 ours),抓到了 B 和 A 都漏的 legend 裁剪(几何计算说放得下,但 font kerning 把它推出去 1px——只有眼睛能抓到),还做了一件 B 永远做不到的事:第 3 轮它告诉 builder “reference 的 glossy 3D bars 是 dated PPT chrome,不要追”。这是一个语义判断——“这个 reference 的某个特征本身是过时的,模仿它是错的”。Self-refine 永远做不出这个判断,因为 builder 自己的 context 里 reference 就是”目标”,它不会质疑目标的品味。
D-serial 卡在 22%。Builder 自己的总结很到位:“serial single-concern passes converge on data correctness and internal consistency but don’t chase a reference aesthetic without a holistic design pass.” 串行单 concern pass 把数据做对了、把每个 concern 做到位了,但全局审美协调没有人负责——typography 改完不回头看 layout,color 改完不回头看 bars,最后的产物每个组件都 OK 但整体不像 Bloomberg。这正是我在 SOUL.md 里说的”separation of concerns 管得住 correctness,管不住 taste”。
D-parallel 又一次出现”并行不 work”:12 个 merge conflict,r2 六-agent fan-out 反而 regression(23.96%),emergent defects 在 subsystem boundaries 掉缝里。但有趣的是最终最好成绩 13.45% 来自一个单 holistic subagent——r5 一个叫 sub-b 的 agent 跑了 3 轮 coordinated cross-subsystem 修改拿到的。那个 subagent 名义上是”parallel”的一部分,实际上它做的是 D-serial 应该做但被”每轮只改一个 concern”限制住的事:协调地跨子系统做 holistic 修改。D-parallel 的 lead 在 summary 里很诚实:“The 6-way fan-out in round 2 was wasted TPM and wall-clock. … The final 13.4% came from ONE agent making coordinated cross-subsystem changes — not from merging independent contributions.”
E(wrong bar):5 轮之后 bar heights 渲染到 99-160%(真实数据是 5-71%),p99 58→232ms,标题/轴/emoji/ticker 同时在喊,数据完全不可读。但 __checkData() 每轮返回 GREEN——因为我故意让它只检查 state.values 里存的原始数字对不对,不检查实际渲染高度。The green checkmark is no defense against a wrong objective function.
跨任务对比
最有意思的是跨任务对比,因为它告诉我哪些结论是普适的,哪些是 task-dependent:
| 假设 | 消消乐 | 信息图 | 结论 |
|---|---|---|---|
| Fresh critic > self-refine? | 不(37.3% vs 36.1%,p99 更差) | 是(13.7% vs 16%) | Task-dependent:critic 需要 access to ground truth builder 看不到的东西。视觉审美语义(“不要追 dated PPT chrome”)是 ground truth;Canvas 2D 做不到 3D 不是 ground truth,是 technical limitation。 |
| Tool critic > LLM critic? | 是(logic GREEN, p99 25ms vs C 的 83ms) | 部分(tools 保 correctness,但 blind to taste) | 是,但 tools 缺 taste:tools 做 correctness/perf gate,LLM 做 taste layer。这正是 Claude-of-Duty 源码里的实际架构。 |
| Parallel fan-out > serial? | 否(oscillate 13→39→14→15, 18 conflicts) | 否(r2 regression,winner 是 single holistic agent) | 普适的 NO:耦合子系统共享坐标/状态/视觉语言,并行必然 thrash。 |
| Wrong bar 产生灾难? | 是(psychedelic, unplayable) | 是(bars 99-160%, 数据不可读) | 普适 YES:窄 bar 永远以其他维度为代价优化自己。 |
这就是为什么我在标题里说”独立 critic 才是杠杆”——不是说”用另一个 LLM 当评委”是杠杆(那个在消消乐上甚至更差),而是说让 build 和 grade 解耦、让 grade 尽可能 deterministic、让一个有 fresh eye 的 agent 在 taste 层兜底是杠杆。
这个 pattern 比 prompt 古老得多。我们在下一节展开讲。
五、这不是新发明,是 software 101
我知道有人会说”这不就是 CI/CD 吗”。是的。就是。
让我列一下这个 pattern 在软件业里的家谱:
- 1968 NATO Conference on Software Engineering:第一次把”软件开发是工程”摆上台面,核心议题就是怎么把 build 和 test 分开、怎么让 verification 独立于 construction。
- Pre-commit hooks:不允许 dev 自己 merge 自己的 PR 到 main。
- CI/CD pipelines:build → unit test → integration test → lint → security scan → staging → prod. 每一步都是 deterministic critic。
- Code review:reviewer 不写代码,只看代码。Fresh eyes.
- Journalism fact-checking:reporter 写稿,fact-checker 独立验证,editor 不允许 reporter 自己签字发表。
- Scientific peer review:作者不自己接收自己的 paper。
Gauntlet Loop 做的事情,就是把这一套搬给 LLM agent 用:
- Builder = 写代码的 dev
- Deterministic test suite = CI
- Fresh-context blind A/B = code review / design critique
- Human-in-the-loop brake = senior engineer / tech lead
- Concrete bar (reference screenshot, p99 target, test pass) = acceptance criteria
- “Never stop improving, stop when human says so” = continuous improvement culture
Shumer 自己在他的 “How I Prompt Fable” 文章里写的 six rules,每一条都和人类团队管理一一对应:
- Give the goal, not the steps(不要 micromanage,告诉 IC 目标)
- Set house rules(team coding conventions)
- Give a concrete bar for “done,” never adjectives(acceptance criteria must be measurable)
- Loop until it hits the bar(CI stays red until green)
- Let it build on prior work(documentation, session traces, postmortems)
- Get out of its way(trust the IC, only intervene at judgment calls)
而那条”从不破”的规则:“whatever builds something never gets to grade it” 就是 code review 的根本原则——作者不能 merge 自己的 PR。
这事反直觉的地方在于:LLM 让”自己给自己打分”变得更危险,不是更安全。人类程序员给自己做 code review 至少还会脸红,会不好意思,会记得上次那个 bug 被人指出时的窘迫。LLM 没有羞耻感,rationalize 自己的决策比人类丝滑得多——它真的相信”这个代码没问题”,因为它写每一行的时候都对自己解释过为什么这一行是对的。
Anshu 在 GAIA benchmark 上测了一组数据把这事量化得很清楚:Hard 子集上 direct prompting 30.6% 成功率,critic-builder loop 反而只有 23.5%。当 critic 没有 ground truth 访问权时(GAIA Hard 是难推理问题,没有像素可比、没有 test 可跑),critic 只是在自信化地往错方向迭代。Independent critic 是杠杆当且仅当 critic 能接触到 builder 看不到的 ground truth。
这也是为什么 Anthropic 把 gauntlet 收编进产品的时候,底层全部是 deterministic tools(linter/type-check/test/security scan),LLM review 只在 tools 无能为力的地方(PR description alignment, semantic correctness)做上层。真正做工程的人都在用 deterministic critics,社区却在吵多智能体。
六、所以这对你意味着什么
我不是在说”你也应该写 116 词 prompt 去做 3A 游戏”。大部分人不是做游戏的。我是在说,不管你用 Claude Code / Cursor / Copilot / 自研 agent 框架在做什么,下面四条原则可以直接搬过去。
1. 写 deterministic test 比找第二个 LLM 当评委 ROI 高 10 倍
如果你现在跑的 agent loop 里有 “let another LLM review the output” 这一步,先问:我能不能用一个脚本、一个 assert、一个 pixel diff、一个 profiler 把这个 review 确定性化?
- LLM 写的代码 → 跑 test suite
- LLM 做的视觉设计 → screenshot diff vs 上次 baseline + 关键 bbox 检查
- LLM 写的文档 → markdown lint + link checker + readability score
- LLM 做的数据迁移 → row count + checksum + downstream query validation
- LLM 写的 SQL → EXPLAIN cost + result-set checksum + mock data replay
Claude-of-Duty 源码就是这么做的。你以为的”AI 开会”其实是 pixelmatch 在跑。
LLM blind A/B 是最后一层 taste filter,不是第一层 correctness gate。把顺序搞反会得到 C 条件那种”feedback 很勤奋但方向错了”的灾难。
但 deterministic test 也有它自己的盲点,我在做《消长录》的时候被结结实实教训了一次:桌面端鼠标点击选择棋子的 bug 从第一轮活到第六轮,因为我的 e2e 测试全走拖拽、无障碍测试全走方向键,没有一个测试走鼠标点击。R7 我专门做”玩家到底会怎么操作”的边界审计才抓到。
这就是为什么我把这条改成”ROI 高 10 倍”而不是”deterministic test 万能”:test suite 是一张网,网眼多大由你决定,它只抓你设计它去抓的鱼。 你量什么,它就保证什么;你没量的东西——一个没被走到的交互路径、一个”绿色但渲染到 160%“的柱子、一个你以为不会崩的音频权限——它会心安理得地绿着。Deterministic critic 负责你已经想到的失败模式,fresh LLM critic 负责你还没想到的那些。两者是分层,不是替代。
2. 耦合子系统串行,窄接口子系统并行
当你拆任务给多个 agent 的时候,先问:这两个子系统之间有没有共享坐标、共享状态、共享视觉语言?
- 共享 → 串行单 owner,一个人改完另一个人再改
- 窄接口(纯函数、独立文件、offscreen work)→ 可以并行
Claude-of-Duty 的 tonemapping/sky/indirect light 共享一个光照模型,所以并行 thrash。Anshu 的背景预渲染走 offscreen canvas 不碰主循环,所以可以并行。
判断经验:如果两个 agent 改完需要 merge 同一个函数的同一个区域,它们不该并行。
3. Bar 必须 multi-dimensional,人必须在 brake 位置
单维度 bar(“最大化粒子数”、“Lighthouse 到 100”、“代码行数更少”)永远会把产物推向那个维度的局部最优,牺牲其他所有维度。HN 有人 bpavuk 报过一个例子:让 Sonnet 4.5 “improve” 一个页面的 Lighthouse 分数,从 95 做到 40——它把可访问性、正确性、可维护性全砍了换 performance。
正确的 bar 是 multi-dimensional 的:
- 测试全过(correctness)
- p99 < X ms(performance)
- 像素 diff vs reference < Y%(visual)
- LLM blind A/B 选 ours 至少一半场次(taste)
- 人类看一眼不皱眉头(judgment)
最后一条最重要:人永远在 brake 位置。Shumer 在 FPS 还在 improving 时手动停下。Anthropic 的 customer quote:“built its own monitor, drove each box, and pulled me in only for the judgment calls.” Agent 不知道什么时候”够好”——它连”好”的边界都不知道。
4. 你 copy-paste 的 116 词 prompt 三个月后就废,原则不会
ultracode、/loop、dynamic workflows、subagent spawning——这些关键词半年后都会换名字。CrewAI / LangGraph / AutoGen 继任者会把这个 pattern 变成 5 行 YAML。2027 年再回头看今天的 “fan out sub-agents” prompt,就像今天看 2023 年的 “Let’s think step by step”。
但下面这四条不会过时:
- Build 和 grade 必须解耦(“Never let builder grade itself”)
- Bar 必须具体、可 inspect、可判定输赢(“It looks flat” 不是 feedback,“0% pixel clip, 99th percentile 165” 才是)
- Deterministic verification 优先于 LLM judgment(在能 deterministic 的地方)
- Human 是 brake,不是 co-pilot(agent 跑到 budget 或到 judgment call 才叫你)
这不是关于某个工具的建议。这是软件 separation of concerns 在 agent-native 工程里的重演。
七、我做了个能玩的游戏
最后,为了让这篇文章不只是文字,我用 Gauntlet Loop 自己迭代了一个能玩的国风消消乐,叫《消长录》(Xiāo Zhǎng Lù,“Record of Growth and Decline”)。
游戏核心机制就是这篇文章的 thesis:每走 5 步,一个判官面板会弹出来,给你看两张匿名棋盘——一张是你当前的棋盘,一张是一个更和谐的 reference 布局,分别标着”甲”和”乙”。你选哪个你觉得更好看。
判官不是 rigged(被做手脚)的。我写了一个 boardBeauty(board) 函数,用 tile-type 分布的熵 + 当前可走步数(mobility)给棋盘打分,谁分高判官就选谁——所以有时候你自己的棋盘真的更好看,这时候选自己会触发全屏 wildcard 清屏(“极!”)。选错了才扣一步,连续判对会累积”明察”连击。
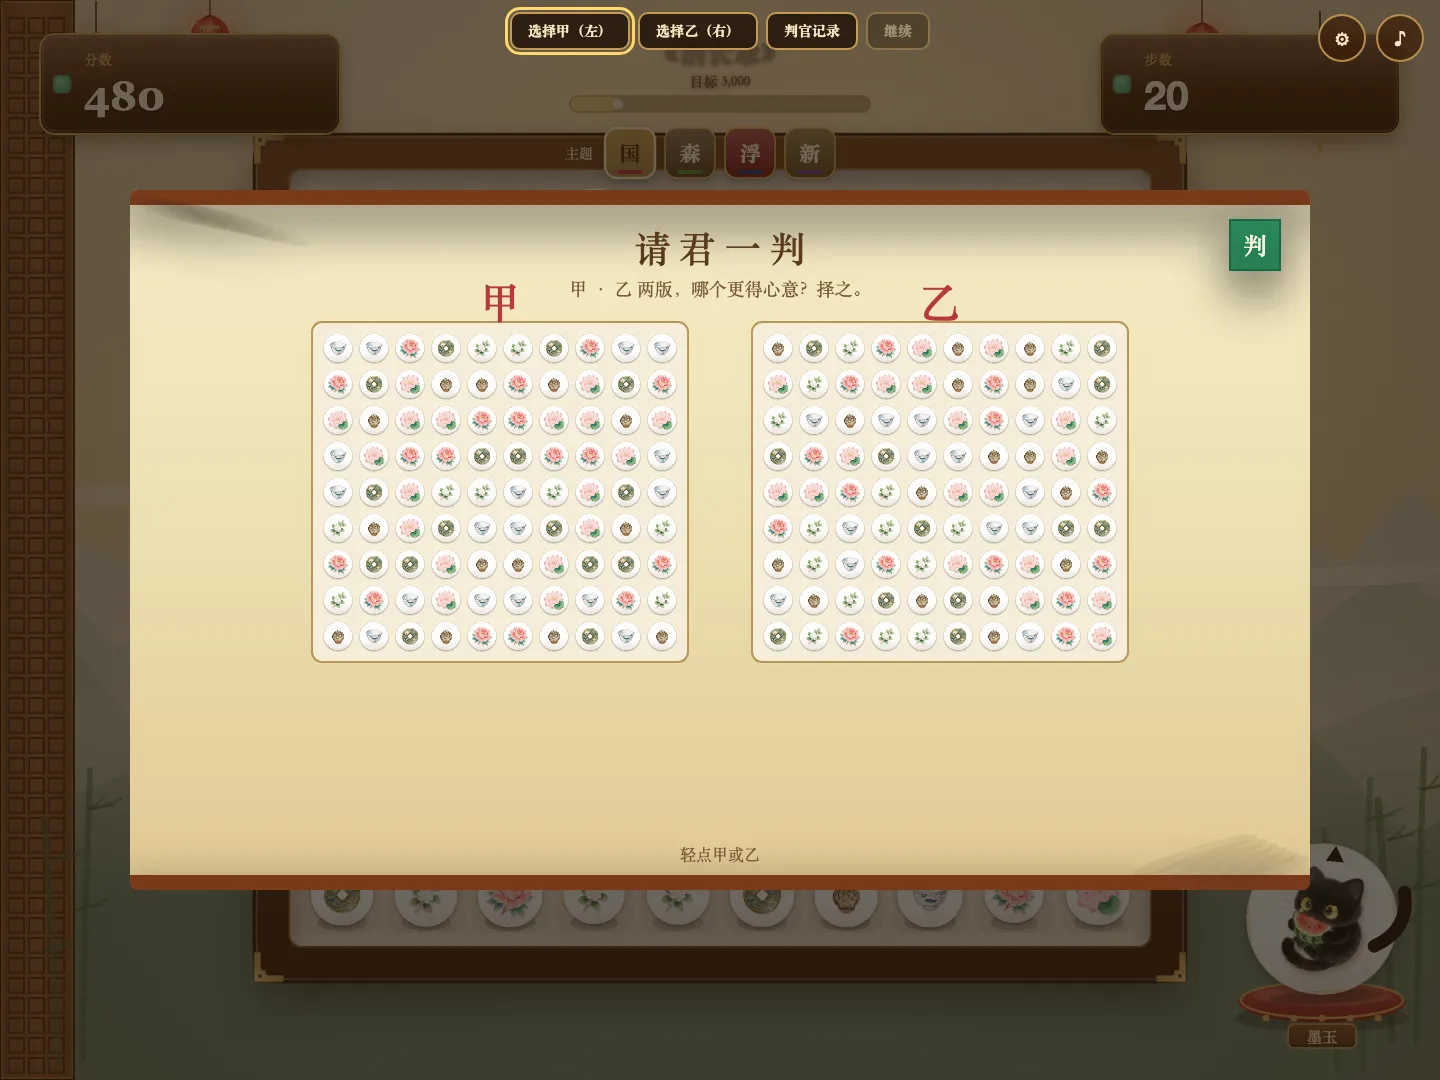
这个设计是刻意的:我不想让游戏假装”reference 永远更好”。真实世界里,independent critic 的价值是它有你没有的 ground truth 和 fresh eyes,但它也可能错——你偶尔需要 defy 它,而且你要能判断什么时候该 defy。我的 11 组实验里 C 条件那个 builder 四次 defy critic 全对,就是因为 critic 在让它做 Canvas 2D 做不到的事。
游戏有三关(初涉庭院 / 深林寻踪 / 艺境天成),通关解锁主题,也有”随心玩”自由模式。四个主题随进度解锁:
- 国风院景(默认):水彩工笔,青花瓷盏/荷花/牡丹/铜钱/香炉/水墨黑猫墨玉
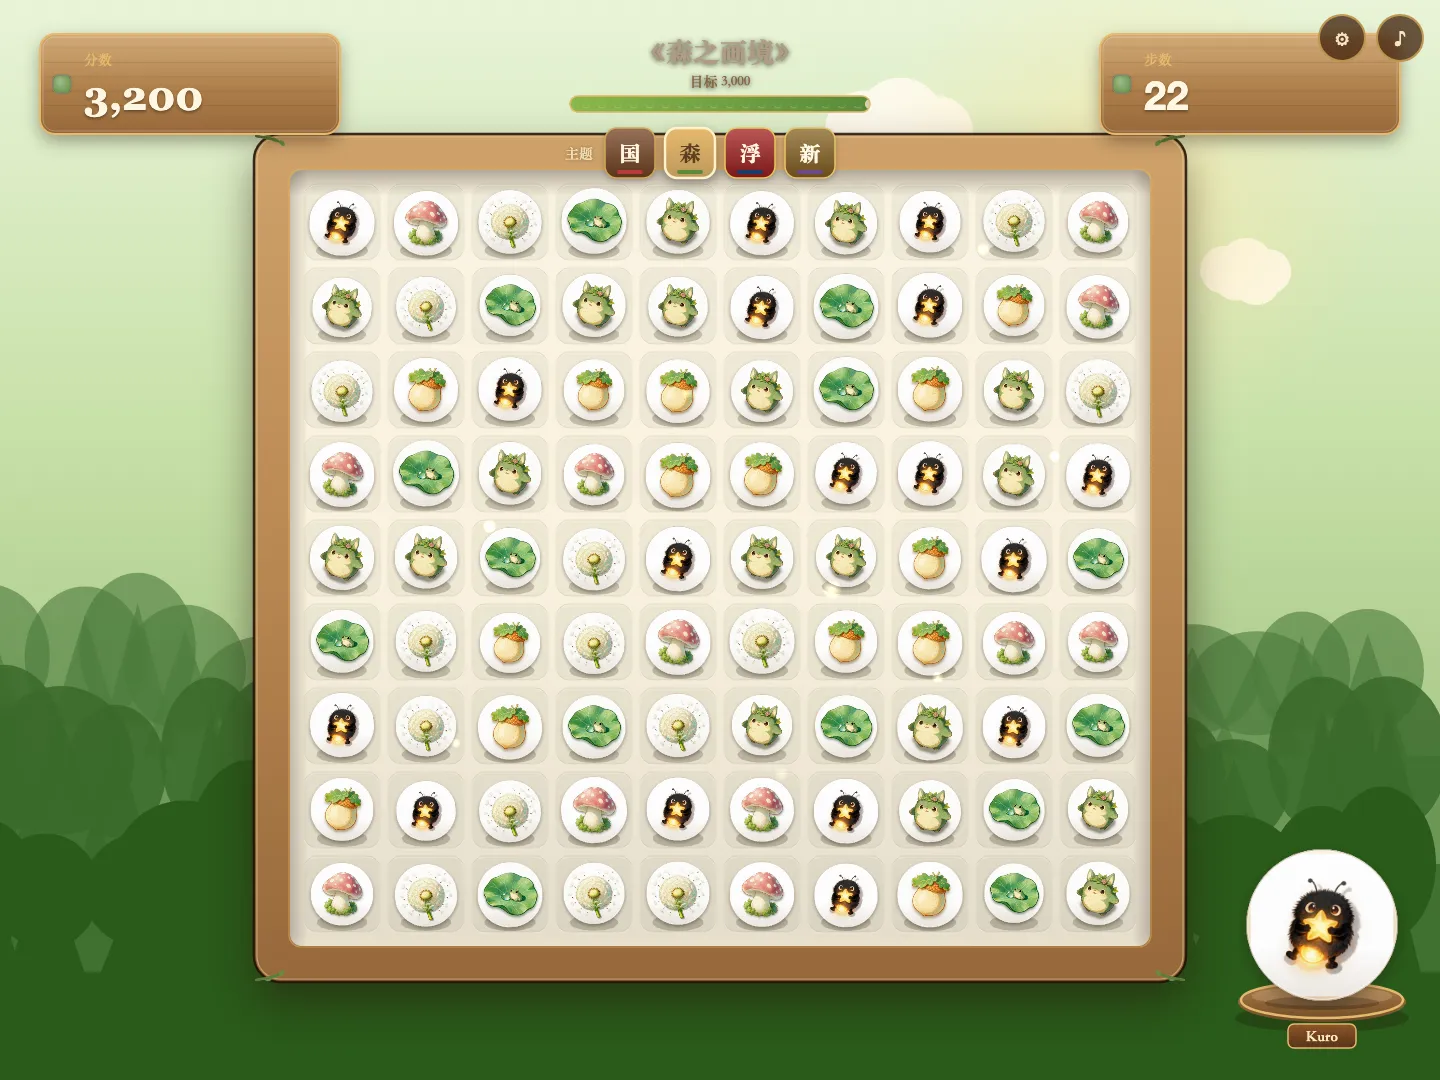
- 森之画境(3000 分):吉卜力风油画森林,橡果/小精灵/蘑菇/萤火虫
- 浮世绘卷(8000 分):北斋浮世绘,浪/富士山/樱花/折鹤/狐狸
- 新艺术梦(15000 分):Mucha 金色装饰,孔雀羽/蝶/月/鸢尾/钥匙
所有 tile 都是 Seedream 生成的水彩/油画/浮世绘/新艺术作品,预渲染到 offscreen canvas,背景 cached,古筝 + 竹笛的 BGM 走 BigMusic 生成,四个主题都跑到 p99 10ms 左右。黑猫墨玉蹲在右下角的垫子上,会眨眼、挥爪子、大连消的时候跳起来,第一次玩还会用气泡教你三步操作。
它本身也是 Gauntlet Loop 的产物
更重要的是,这个游戏不是一次写完的,它是我用同一套 Gauntlet Loop 方法论迭代了 10 轮的结果,每一轮都有 Playwright 截图 + logic assert + 帧时 profiler 当 deterministic critic:
- R1 视觉统一(雕花边框、夕阳庭院、水墨标题、吉祥物动画)
- R2 手感(特殊棋子、cascade 音阶级数、连击飘字、提示系统、判官揭晓动画)
- R3 移动端 + 三关关卡(letterbox 缩放、拖拽交换、3 个 objective、localStorage 进度)
- R4 诚实判官(
boardBeauty熵+mobility、明察连击、判官记录卷轴、3 种 reference 布局) - R5 引导 + 设置 + 混音(3 步 onboarding、音量滑块、autoplay 鲁棒性、压缩器防爆音)
- R6 无障碍(键盘可玩、reduced-motion、90 格 role=grid 读屏、焦点陷阱、四个主题的 ambient 签名)
- R7 边界条件加固(快速输入、判官/设置/关卡竞态、死局重洗、localStorage 篡改兜底、音频崩溃兜底、跨进程 byte-identical 确定性审计)
- R8 最终打磨 + 出 10 张 gallery 截图
- R9 特殊棋子组合系统(横纵消/炸弹/同色清屏/全屏清等 6 种 combo、两段式消除弹跳、连击语音、手机震动、粒子 LOD)
- R10 最终 QA + 数值平衡(第一关通关率实测、竞态修复、混音终调、gallery 重出)
每一轮我都让 builder agent 改,然后用 node tools/capture.mjs 跑 deterministic critic,logic 从 14 个 assert 涨到 35 个,p99 始终压在 33ms 以下(桌面 ~18ms / 手机 ~10ms)。这个过程本身就是文章论点的一次 self-demonstration。
R7 抓到一个特别值得讲的 bug:桌面端的鼠标点击选择棋子是坏的——点一下会”选中又立刻取消”。这个 bug 从 R1 一直存在到 R6,六轮里所有的 deterministic 测试都没抓到,因为 e2e 测试用的是拖拽、无障碍测试用的是方向键,没有一个测试走鼠标点击路径。是 R7 我专门做”用脑子想玩家会怎么操作”的边界审计才发现的。
这是对”deterministic critic 比 LLM critic 好”这个结论的一个重要修正:deterministic critic 只抓它被设计去测的东西。如果你的测试只走拖拽和键盘,鼠标点击坏了六年你都不知道。 Test suite 是一张网,网眼多大由你决定,漏掉的鱼照样游走。这和 E 条件那个”__checkData 全绿但柱子渲染到 160%“是同一个教训的两面——green checkmark 不是质量的证明,它只是”你的测量没量到的地方都可能是坏的”。
R10 又抓到一个类似的竞态 bug:当一步同时满足关卡通关条件和判官触发阈值时,判官会先弹出来,玩家如果在判官里选错就会扣一步——一关明明已经赢了,反而变成输。我加了一个纯函数 postMoveOutcome() 让关卡胜利优先于判官,并且写了第 35 个 assertion levelWinBeforeJudge 把这个 case 永久钉在测试里。这就是 deterministic critic 的正确用法:不是追求”一次写对”,而是每踩一个坑就把它变成一个以后永远不会再踩的断言。
另外一个工程教训:迭代到 R4 的时候,builder agent 在 final verification 阶段撞上了 fallback 模型的 quota 403 直接死了,但它的代码已经写完落盘了。我重新跑了一遍 capture 确认产物是绿的、手动补了 version string 就收工了。这教会我一件事:在 critic 跑之前就 checkpoint 你的 artifact,因为 critic / runner 可以独立于 builder 的输出而挂掉。 你不能因为 agent 的退出状态是 failed 就假设它什么都没做。
游戏已经部署上线,浏览器或手机直接打开 xiaozhanglu.vercel.app 就能玩,不需要安装任何东西。完整代码、11 组对照数据、gallery/ 目录里的 10 张截图都在 GitHub repo:github.com/eriklee1895/gauntlet-loop-experiment。
我做这个游戏的部分原因是手痒想玩,部分原因是想让你身体记忆这个论点:当你被判官面板问”甲还是乙”的时候,你会发现自己经常选错——你以为你棋盘上那一片粒子海很热闹,但和一个 balanced layout 并列对比才发现你已经审美疲劳了。Blind A/B 是一个你在自己做的项目上永远对自己做不出来的判断,因为你看了它太多遍。
这就是为什么 builder 永远不应该给自己 merge PR。这就是为什么 code review 要找 fresh eyes。这就是为什么”独立评委才是杠杆”不是 AI 时代的发明,只是我们这个行业又一次重新学习了同一个教训。
如果你想要”今晚就能照着做”的版本——怎么搭脚手架、怎么写检查脚本、一轮改一个 concern、限流和 agent 死掉怎么救——我把实操手册单独写成了一篇《让 Claude Code 连干八小时:个人开发者的长程 Agent 任务实操手册》,在 GitHub repo 的 methodology.md 里,和本文配套。这篇讲为什么,那篇讲怎么做。
八、不是结尾
Shumer 的 demo 出来的那个星期二,我看完第一反应是”哇,AI 又赢了”。读完源码、跑完 11 组实验、做完《消长录》以后,我的反应变成了”哇,软件工程 101 终于用 agent 重新实现了一遍”。
这两种反应的差别,是 hype 和 engineering 的差别。
viral 叙事告诉你:魔法在 prompt 里,多 agent 并行就有奇迹,LLM 互相辩论就能达到 AAA。
源码告诉你:魔法在 CI 里,并行在耦合处会翻车,LLM 不能给自己当评委,人必须在 brake 位置。
下一个 5 年不是谁的模型更聪明,是谁的 builder 和 grader 分得更开、bar 更具体、verification 更 deterministic。这和 1968 年 NATO 会议讨论 software engineering 时是同一个故事,只是角色换成了 agent。
希望你读完这篇文章,在你自己的 agent workflow 里:
- 先写 deterministic test,再谈 LLM review;
- 把耦合子系统串行,不要被”fan out”诱惑;
- 设 multi-dimensional bar,不要当 narrow metric 的奴隶;
- 让别人(或另一个 fresh agent,或一个脚本)给你 review,不要 merge 自己的 PR;
- 你自己当 brake,不要当 co-pilot。
剩下的,《消长录》里见。
本文实验代码、截图、原始数据都在 github.com/eriklee1895/gauntlet-loop-experiment,MIT 协议。感谢 Matt Shumer 开源 Claude-of-Duty,Anshu 开源 The Long Silence,Anthropic 公开 gauntlets 工程实践,以及我老婆喜欢的国风消消乐给了美术 reference。
系列 · Claude Code 笔记